
1. AI 시대 엔터프라이즈 데이터 아키텍처의 진화
1.1 세대별 아키텍처와 한계
| 세대 | 핵심 아이디어 | 강점 | 구조적 한계 | 대표 기술 |
|---|---|---|---|---|
| 데이터 웨어하우스(Data Warehouse, DW) | 스키마 온 라이트(Schema-on-Write), 정제된 정형 데이터를 중앙 집중 | 강한 일관성, SQL 성능, 거버넌스 용이 | 비정형 데이터 수용 불가, 스토리지·컴퓨트 결합으로 비용 경직, ML 접근 어려움 | Teradata, Oracle Exadata, Amazon Redshift |
| 데이터 레이크(Data Lake) | 스키마 온 리드(Schema-on-Read), 원본을 저가 객체 스토리지에 적재 | 유형 무관 수용, 저비용, ML 친화 | ACID 부재 → 데이터 스웜프(Data Swamp), 품질·계보 불명, 동시 쓰기 충돌 | HDFS, Amazon S3 + Hive |
| 레이크하우스(Lakehouse) | 객체 스토리지 위에 오픈 테이블 포맷(ACID, 스냅샷, 스키마 진화) | DW 수준 신뢰성 + 레이크 유연성, 스토리지·컴퓨트 분리, 멀티 엔진 | 카탈로그·컴팩션 운영 부담, 소규모 지연 민감 OLTP 부적합 | Apache Iceberg, Delta Lake, Apache Hudi |
| 데이터 메시(Data Mesh) | 도메인 소유, 데이터를 제품(Data as a Product)으로, 셀프서비스 플랫폼, 연합 거버넌스 | 조직 확장성, 도메인 지식 반영 | 조직 성숙도 요구, 표준 미비 시 사일로 재발 | 조직 원칙 + (DataZone/SageMaker Catalog, DataHub) |
| 데이터 패브릭(Data Fabric) | 액티브 메타데이터·지식 그래프로 분산 데이터를 가상 통합 | 물리 이동 최소화, 자동 거버넌스 | 메타데이터 품질 의존, 가상화 쿼리 성능 한계 | Denodo, Informatica, Starburst, Trino |
핵심 판단: 메시와 패브릭은 대립 개념이 아니다. 메시는 조직·소유권 모델, 패브릭은 기술·메타데이터 모델이다. 실무에서는 “레이크하우스를 물리 기반으로, 메시 원칙으로 도메인을 나누고, 패브릭(카탈로그+리니지+정책 엔진)으로 묶는” 조합이 일반적이다.
1.2 Data Mesh vs Data Fabric 선택 기준
| 기준 | Data Mesh 선택 | Data Fabric 선택 |
|---|---|---|
| 조직 | 도메인 팀이 데이터 엔지니어링 역량 보유, 사업부 자율성 큼 | 중앙 데이터 조직이 강하고 도메인 역량 부족 |
| 데이터 분산도 | 다수 도메인이 각자 플랫폼 운영 | 레거시 시스템 다수, 물리 이동 비용 큼 |
| 거버넌스 | 연합(Federated) 거버넌스로 표준 강제 가능 | 중앙 메타데이터 자동화로 통제 |
| 리스크 | 표준 없으면 사일로 재발, 4원칙 중 “셀프서비스 플랫폼” 미비 시 실패 | 메타데이터 품질이 낮으면 “가상 스웜프” |
보험사 맥락 예시: 계약·보상·영업·자산운용 등 도메인별 시스템이 명확히 나뉘고 규제 리포팅이 중앙 집중이라면, “도메인 데이터 프로덕트 + 중앙 거버넌스(패브릭형 카탈로그)” 하이브리드가 현실적이다.
1.3 AI 워크로드가 요구하는 새로운 요구사항
| 요구사항 | 왜 필요한가 (ML / LLM / RAG / 에이전트) | 데이터 구조에 주는 함의 |
|---|---|---|
| 비정형 데이터의 일급 시민화 | 약관·청구서·녹취·이미지가 RAG의 핵심 코퍼스 | 문서→청크→임베딩 계보 테이블, 객체 스토리지 + 메타데이터 테이블 분리 |
| 벡터(Vector) 저장·검색 | 의미 검색, 시맨틱 캐시, 추천 | 벡터 인덱스 계층 추가, 임베딩 모델 버전을 스키마에 포함 |
| 실시간성 | 온라인 피처, 에이전트의 최신 상태 조회, 사기 탐지 | CDC → 스트리밍 → 온라인 스토어/벡터 인덱스 증분 갱신 |
| 재현성(Reproducibility) | 모델 감사, 학습 재현, 규제 설명 책임 | 스냅샷·타임트래블, 데이터셋 버저닝, 피처의 point-in-time 보장 |
| 거버넌스·계보 | 개인정보·저작권·모델 리스크 관리 | 컬럼 수준 PII 태깅, 리니지 그래프, 데이터 컨트랙트 |
| 평가 가능성(Evaluability) | RAG/LLM 품질은 골든셋 없이는 측정 불가 | 골든셋·라벨·평가 결과를 데이터 자산으로 관리 |
| 에이전트 접근성 | 에이전트가 도구로 데이터를 호출(Text-to-SQL, API) | 시맨틱 레이어·메트릭 정의·권한이 기계 판독 가능해야 함 |
1.4 AI 네이티브 데이터 플랫폼 레퍼런스 구조
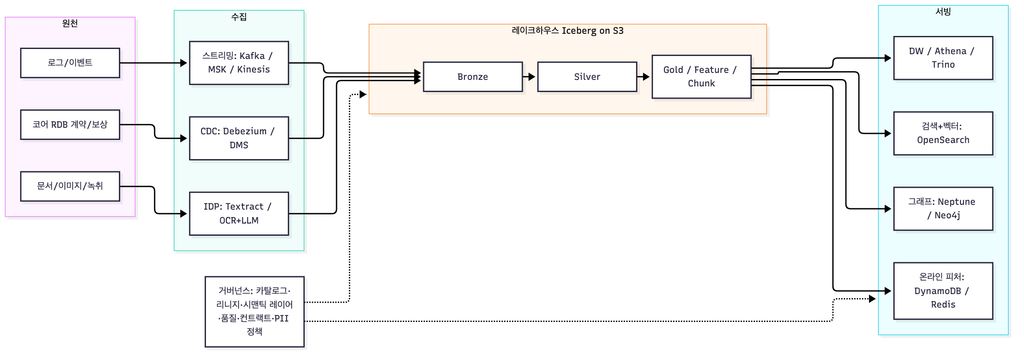
▶ 포인트
- 세대 전환의 배경을 "한계 → 해결"의 인과로 서술하라(예: 레이크의 ACID 부재 → 오픈 테이블 포맷).
- AI 요구사항은 반드시 “비정형·벡터·실시간·재현성·거버넌스” 5개 축으로 구조화해 답하라.
- 메시 vs 패브릭은 "조직 모델 vs 기술 모델"이라는 한 문장으로 관계를 정리하고, 하이브리드 채택 근거를 제시하라.
- 트레이드오프: 중앙 집중(일관성·거버넌스 용이) vs 분산(민첩성·도메인 지식) — 어느 쪽을 택하든 비용을 명시.
2. 레이크하우스와 오픈 테이블 포맷
2.1 레이크하우스가 해결하는 문제
레이크하우스의 본질은 "객체 스토리지(S3/GCS/ADLS/MinIO) 위의 파일(Parquet/ORC)을 테이블로 승격시키는 메타데이터 계층"이다. 테이블 포맷이 제공하는 것은 ① ACID 트랜잭션(낙관적 동시성), ② 스냅샷 격리와 타임트래블, ③ 스키마·파티션 진화, ④ 파일 수준 통계 기반 프루닝, ⑤ 다중 엔진 호환(Spark, Trino, Flink, Athena, Snowflake 등)이다. 이로써 DW와 레이크를 두 벌 운영하며 발생하던 이중 적재·불일치·비용을 없앤다.
2.2 Apache Iceberg / Delta Lake / Apache Hudi 비교
| 항목 | Apache Iceberg | Delta Lake | Apache Hudi |
|---|---|---|---|
| 기원·거버넌스 | Netflix → ASF, 다수 벤더 공동 기여 | Databricks 주도(Linux Foundation) | Uber → ASF(Onehouse 주도) |
| 메타데이터 구조 | 스냅샷 → 매니페스트 리스트 → 매니페스트 → 데이터 파일(계층형, 엔진 무관) | 트랜잭션 로그(_delta_log JSON + 체크포인트 Parquet) | 타임라인(.hoodie) + 파일 그룹/슬라이스 |
| 파티션 | 히든 파티셔닝(Hidden Partitioning), 파티션 진화 | 파티션 컬럼 명시(Liquid Clustering으로 보완) | 파티션 명시, 클러스터링 서비스 |
| 업데이트 방식 | COW(Copy-on-Write) / MOR(Merge-on-Read), v3 삭제 벡터 | COW 기본, 삭제 벡터 | COW / MOR 테이블 타입, 레코드 키 기반 upsert에 최적 |
| 스트리밍·CDC | Flink/Spark 지원, v3 행 계보(row lineage) | Spark Structured Streaming 강점, CDF(Change Data Feed) | 증분 쿼리·CDC 내장(가장 오래된 강점) |
| 카탈로그 | REST Catalog 사양(벤더 중립), Glue/Hive/Nessie/Polaris/JDBC | Unity Catalog, Hive | Hive, Glue, DataHub 동기화 |
| 엔진 생태계 | Spark, Trino, Flink, Athena, Redshift, Snowflake, BigQuery, Dremio, DuckDB | Spark 중심, UniForm으로 Iceberg 메타데이터 생성 | Spark, Flink, Trino(읽기), Presto |
| 선택 시점 | 멀티 엔진·멀티 벤더, 장기 중립성, 파티션 진화 필요 | Databricks 중심 조직, Spark 단일 엔진 | 고빈도 upsert/CDC, 레코드 키 명확, 자동 테이블 서비스 필요 |
| 비선택 시점 | 극도의 upsert 빈도(초단위)엔 MOR 컴팩션 운영 필요 | 비(非)Databricks 엔진에서 쓰기 호환 제약 | 커뮤니티·엔진 호환 폭이 상대적으로 좁음 |
2.3 2026년 기준: Iceberg 사실상 표준화의 흐름 (검색 확인)
- 포맷 전쟁의 종결: 2024년 Databricks의 Tabular 인수 이후 Delta와 Iceberg의 상호운용(UniForm, Iceberg REST 지원)이 가속되었고, 2026년 시점의 업계 평가는 "포맷 전쟁은 Iceberg가 이겼고 이제 카탈로그가 경쟁 무대"로 요약된다.
- Iceberg 포맷 v3: Apache Iceberg 1.10.0에서 v3 기능이 GA로 편입되었다 — 바이너리 삭제 벡터(Deletion Vector), VARIANT 반정형 타입, 나노초 타임스탬프, 지리공간 타입, 컬럼 기본값, 행 수준 계보(row lineage). Snowflake는 2026년 5월 Iceberg v3를 GA로 지원했고 Databricks도 v3 지원을 공개했다. 행 계보는 규제 산업의 감사 추적과 네이티브 CDC에 직접 활용된다.
- REST Catalog 사양이 기본 선택으로 정착: 2023년 공식화된 Iceberg REST Catalog 사양이 2026년 신규 구축의 기본 선택이 되었다. Apache Polaris(Snowflake 기부)는 2026년 2월 ASF 최상위 프로젝트(TLP)로 졸업하며 레퍼런스 구현으로 자리 잡았다.
- AWS 측 변화: Amazon S3 Tables(2024년 12월 GA)가 2025년 3월 Iceberg REST 호환 엔드포인트를 추가했고, AWS Glue Data Catalog는 2025년 11월 원격 Iceberg REST 카탈로그 연합(Catalog Federation) 을 GA로 제공하여 테이블 복사 없이 Athena/Redshift/EMR에서 외부 카탈로그를 조회할 수 있게 되었다.
설계 함의: "오픈 테이블 포맷 = Iceberg, 카탈로그 인터페이스 = Iceberg REST"를 기본값으로 두고, 예외(기존 Databricks 투자, 초고빈도 upsert)가 있을 때만 Delta/Hudi를 정당화하는 것이 표준 논리다.
2.4 카탈로그 선택
카탈로그는 "어떤 테이블이 어디에 있고 현재 메타데이터 포인터가 무엇인가"를 원자적으로 관리하는 지점이다. 포맷보다 카탈로그가 벤더 종속의 실제 지점이다.
| 카탈로그 | 성격 | 강점 | 주의점 | 선택 시점 |
|---|---|---|---|---|
| AWS Glue Data Catalog | 관리형 Hive 호환 + Iceberg REST 연합 | Athena/Redshift/EMR/Lake Formation 권한 통합, 운영 無 | AWS 외부 엔진은 REST 경유, 리전 단위 | AWS 중심 조직의 기본 선택 |
| Amazon S3 Tables | S3 버킷 타입으로 Iceberg 테이블 내장, 자동 컴팩션·스냅샷 만료 | 테이블 유지보수 자동화, 별도 카탈로그 인프라 불필요 | 기능 성숙도·타 엔진 연동은 REST 엔드포인트 의존 | 운영 인력이 적고 AWS 네이티브 분석이 주류일 때 |
| Iceberg REST Catalog(사양) | 벤더 중립 HTTP API | 엔진·벤더 간 상호운용, 자격증명 벤딩(Credential Vending) | 구현체 선택 필요 | 멀티 엔진·멀티 클라우드, 장기 중립성 |
| Apache Polaris | REST 레퍼런스 구현(ASF TLP) | RBAC, 네임스페이스, 자격증명 벤딩, 멀티테넌시 | 자체 운영 필요(Snowflake Open Catalog로 관리형 가능) | 자체 운영 가능한 중립 카탈로그 |
| Unity Catalog(Databricks/OSS) | 테이블·모델·볼륨·함수 통합 거버넌스 | 세밀 권한·리니지·AI 자산 통합 | Databricks 외부에서는 OSS 기능 범위 제한 | Databricks 중심 조직 |
| Project Nessie | Git 방식 브랜치/태그 카탈로그 | 데이터 브랜칭(실험·격리 배포), 다중 테이블 원자 커밋 | Dremio 생태계 의존도 | 데이터 실험·릴리즈 관리가 중요할 때 |
| Lakekeeper / Apache Gravitino | 경량 REST 구현 / 메타데이터 레이크(연합) | Rust 기반 경량 / 멀티 소스 연합 | 성숙도 확인 필요 | 쿠버네티스 자체 운영, 다중 카탈로그 통합 |
2.5 메달리온(Medallion) 아키텍처와 AI 계층 확장
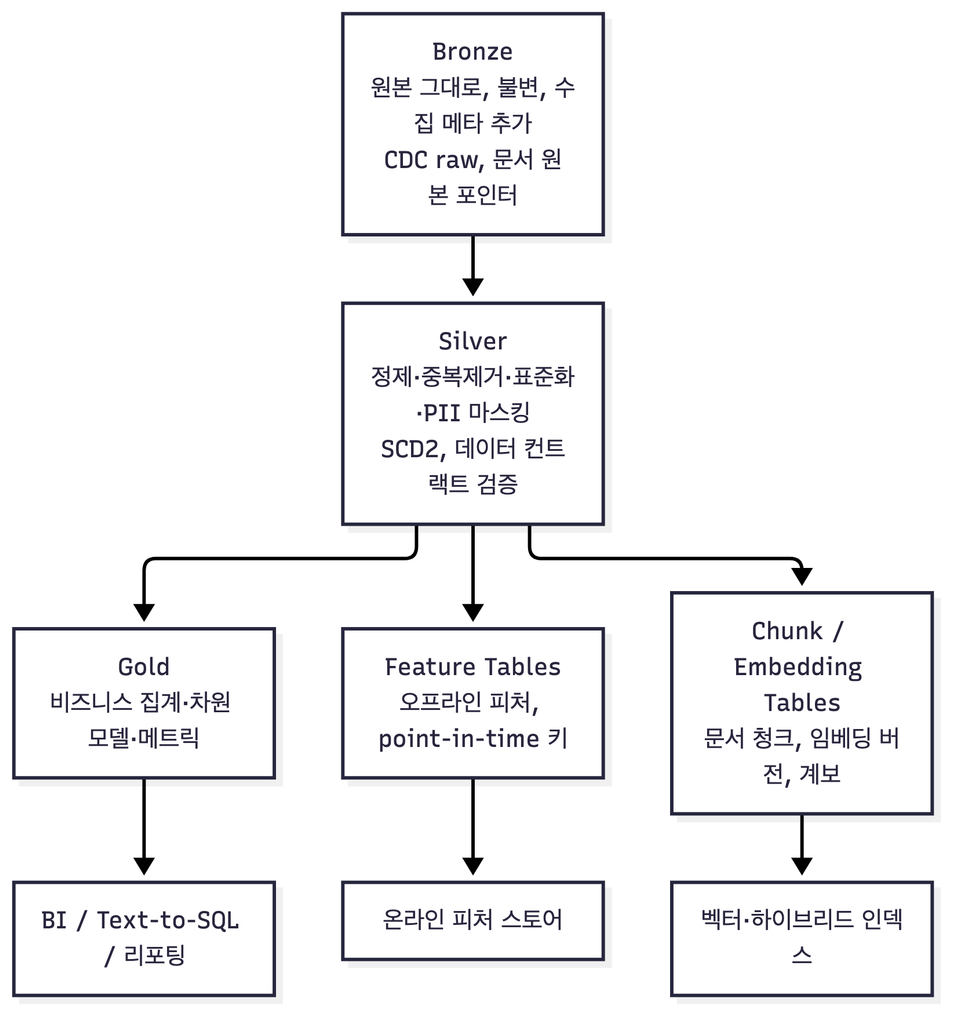
| 계층 | 책임 | 금지 사항 | 보존·권한 |
|---|---|---|---|
| Bronze | 원천 충실 보존(Append-only), 수집 시각·소스·배치 ID 부여 | 변환·삭제(법적 삭제 요청 제외) | 장기 보존, 최소 접근 |
| Silver | 타입 정규화, 중복 제거, 참조 무결성, PII 분류·마스킹, 품질 검증 | 비즈니스 해석(집계·KPI 정의) | 도메인 팀 접근, 컬럼 마스킹 적용 |
| Gold | 소비자 관점 모델(스타 스키마, OBT, 메트릭) | 원천 복원 불가능한 손실 변환을 유일 경로로 두는 것 | 광범위 접근, 시맨틱 레이어 연결 |
| Feature/Chunk(AI 계층) | 학습·추론·검색용 파생 자산, 버전·계보 보유 | 모델/임베딩 버전 없는 적재 | 모델 수명주기와 함께 관리 |
2.6 파티셔닝·컴팩션·스냅샷·타임트래블·스키마 진화
- 파티셔닝: Iceberg는 변환 함수(
days(ts),bucket(16, id),truncate)로 히든 파티셔닝을 제공하여 사용자가 파티션 컬럼을 직접 필터하지 않아도 프루닝된다. 파티션 진화가 가능하므로 처음부터 완벽할 필요가 없다. 과도한 파티셔닝(소형 파일 폭증) 이 가장 흔한 실패다 — 파티션당 파일 크기 128MB~1GB 목표. - 컴팩션(Compaction): 스트리밍/CDC는 소형 파일과 삭제 파일을 양산하므로 주기적
rewrite_data_files,rewrite_position_delete_files가 필수. S3 Tables·Glue 최적화는 이를 관리형으로 제공. 비용·지연 트레이드오프: 자주 컴팩션하면 쿼리 빠르지만 컴퓨트 비용 상승. - 스냅샷·타임트래블: 모든 커밋이 스냅샷을 남기므로
FOR SYSTEM_VERSION AS OF/FOR SYSTEM_TIME AS OF로 과거 조회 가능. 학습 데이터 재현의 핵심. 단, 스냅샷 만료(expire_snapshots)를 하지 않으면 스토리지 비용이 누적되고 삭제 요청(개인정보) 이행이 불완전해진다 — 보존 정책과 개인정보 삭제 의무가 충돌하는 지점을 언급할 것. - 스키마 진화: 컬럼 추가/삭제/이름 변경/타입 승격이 메타데이터 변경만으로 가능(컬럼 ID 기반). 호환성 규칙(하위 호환 추가만 허용 등)은 데이터 컨트랙트로 강제한다(→ 7장).
-- Iceberg (Spark SQL) 예시: 히든 파티셔닝 + 타임트래블 + 유지보수
CREATE TABLE lh.silver.claim (
  claim_id STRING, policy_id STRING, claim_ts TIMESTAMP,
  amount DECIMAL(18,2), status STRING, _ingest_ts TIMESTAMP
) USING iceberg
PARTITIONED BY (days(claim_ts), bucket(16, policy_id))
TBLPROPERTIES ('format-version'='3', 'write.delete.mode'='merge-on-read');

SELECT * FROM lh.silver.claim FOR SYSTEM_TIME AS OF '2026-09-30 00:00:00';

CALL lh.system.rewrite_data_files(table => 'silver.claim',
  options => map('target-file-size-bytes','536870912'));
CALL lh.system.expire_snapshots(table => 'silver.claim',
  older_than => TIMESTAMP '2026-07-01 00:00:00', retain_last => 30);
2.7 설계 판단 요약
| 상황 | 권고 | 근거 |
|---|---|---|
| 신규 플랫폼, 멀티 엔진(Athena+Spark+Trino+Snowflake) | Iceberg + REST 카탈로그(Glue 연합 또는 Polaris) | 중립성, 엔진 호환, 파티션 진화 |
| 이미 Databricks 표준화 | Delta + Unity Catalog, UniForm으로 Iceberg 노출 | 기존 투자 보호, 거버넌스 통합 |
| 초고빈도 레코드 upsert(IoT, 결제 원장) | Hudi MOR 또는 Iceberg v3 MOR + 적극적 컴팩션 | 쓰기 지연 최소화; 읽기 지연·운영 비용 증가 감수 |
| 운영 인력 최소, AWS 네이티브 | S3 Tables | 자동 유지보수; 기능·연동 범위 확인 필요 |
▶ 포인트
- "왜 Iceberg인가"를 중립성(REST 카탈로그)·파티션 진화·v3 행 계보로 근거화하고, Delta/Hudi를 택할 예외 조건도 함께 적어라.
- 카탈로그가 실제 종속 지점임을 지적하고, 연합/REST로 종속을 완화하는 구조를 제시하라.
- 메달리온은 계층별 "책임과 금지 사항"을 명시해야 설계로 인정된다. AI 계층(Feature/Chunk)을 Silver 파생으로 추가하라.
- 트레이드오프: 컴팩션 빈도(쿼리 성능 vs 비용), 스냅샷 보존(재현성 vs 스토리지·삭제 의무).
3. 데이터 모델링
3.1 모델링 기법 비교
| 기법 | 구조 | 강점 | 약점 | 선택 시점 | 비선택 시점 |
|---|---|---|---|---|---|
| 3NF(정규화) | 엔티티 중심, 중복 제거 | 갱신 이상 방지, OLTP 적합, 원천 충실 | 분석 조인 폭발, 비전문가 이해 어려움 | OLTP, 통합 운영 데이터 저장소(ODS) | 분석 서빙 계층 |
| Kimball 차원 모델 | 팩트 + 차원(Star), 정규화 차원(Snowflake) | 비즈니스 친화, BI 성능, 적합 차원(Conformed Dimension) | 소스 변경에 취약, 이력 관리(SCD) 복잡 | Gold 계층, BI/리포팅, Text-to-SQL 대상 | 고변동 소스 통합 저장 |
| Data Vault 2.0 | Hub(키)/Link(관계)/Satellite(속성·이력) | 감사 추적, 소스 변경 유연, 병렬 적재 | 조인 수 많아 직접 분석 부적합, 모델링 비용 | 규제 산업 통합 계층(Silver), 다수 소스, 감사 필요 | 소규모·단일 소스 |
| One Big Table(OBT)/Wide Table | 비정규화 단일 테이블 | 조인 제거, 컬럼형 엔진에서 빠름, LLM이 이해 쉬움 | 중복·갱신 비용, 의미 모호 | ML 피처 뷰, LLM Text-to-SQL 대상, 특정 소비자용 마트 | 다목적 범용 마트 |
| Activity Schema | 단일 활동 스트림(entity, activity, ts, features) | 고객 여정 분석·시계열 질의 단순화 | 집계 재계산 비용, 익숙하지 않음 | 고객 행동·여정 분석, 이벤트 기반 피처 생성 | 재무 정합성 리포팅 |
3.2 Kimball 차원 모델: Star vs Snowflake, SCD
| 구분 | Star Schema | Snowflake Schema |
|---|---|---|
| 차원 | 비정규화(한 테이블) | 정규화(계층 분리) |
| 쿼리 | 조인 적고 빠름 | 조인 증가 |
| 저장 | 중복 다소 | 절약 |
| 권고 | 컬럼형 DW/레이크하우스에서는 Star 기본 | 차원 계층이 매우 크거나 공유 마스터 관리 필요 시 |
SCD(Slowly Changing Dimension) 유형:
| 유형 | 동작 | 사용 예(보험) | 트레이드오프 |
|---|---|---|---|
| Type 1 | 덮어쓰기 | 오타 교정, 이력 불필요 속성 | 이력 소실 |
| Type 2 | 새 행 추가 + 유효기간·현재 플래그 | 고객 주소·직업, 계약 상태 변경(언더라이팅 기준 재현) | 행 증가, 조인 시 유효기간 조건 필요 |
| Type 3 | 이전 값 컬럼 추가 | 직전 등급만 필요할 때 | 깊은 이력 불가 |
보험 Star 예시: 팩트 fact_claim(claim_sk, policy_sk, coverage_sk, date_sk, claim_amount, paid_amount) + 차원 dim_policy(SCD2), dim_coverage, dim_customer(SCD2), dim_date. 포인트: 보험금 심사 모델의 재현성을 위해 dim_customer는 SCD2가 필수이며, Feature Store의 point-in-time 조인도 동일 원리다.
3.3 Data Vault 2.0
- Hub: 비즈니스 키(계약번호, 고객번호)와 해시 키, 최초 적재 시각, 레코드 소스.
- Link: Hub 간 관계(계약-고객, 계약-담보, 청구-계약).
- Satellite: 설명 속성과 변경 이력(해시 디프로 변경 감지).
- 조회 성능 보완: PIT(Point-In-Time) 테이블, Bridge 테이블, 그 위에 Kimball 마트(정보 마트)를 생성.
- 보험 예시:
hub_policy,hub_customer,hub_coverage,link_policy_customer,sat_policy_status,sat_customer_contact. - 선택 근거: 코어 시스템 교체(→ 03장)나 다수 채널 통합 시 소스 스키마 변화를 Satellite 추가로 흡수하고, 감독 당국 감사에 "언제 어떤 소스에서 들어왔는가"를 증명할 수 있다. 비용: 모델링 시간과 조인 복잡도.
3.4 OBT / Activity Schema — AI 관점
- LLM Text-to-SQL은 조인 경로 추론에서 실패가 잦다. 소비자별 OBT + 시맨틱 레이어 메트릭 정의가 정확도를 높인다(→ 5.4).
- Activity Schema는 "고객 X의 최근 90일 활동"을 단일 테이블 윈도우 집계로 만들 수 있어 행동 피처 생성과 에이전트의 맥락 조회에 적합하다.
- 주의: OBT는 "단일 진실 원천(Single Source of Truth)"이 아니라 파생 서빙 뷰다. 진실은 Silver(3NF/Vault)에 두고 OBT는 재생성 가능해야 한다.
3.5 Feature Store
| 구성 | 역할 | AWS 예시 | 오픈소스/벤더 중립 |
|---|---|---|---|
| 오프라인 스토어 | 학습용 대량 이력, point-in-time 조인 | SageMaker Feature Store(오프라인: S3/Iceberg) | Feast(오프라인: Parquet/BigQuery/Snowflake), Hopsworks, Tecton, Databricks Feature Store |
| 온라인 스토어 | 저지연 최신 피처 조회(ms) | SageMaker Feature Store(온라인), DynamoDB, ElastiCache | Feast(Redis/DynamoDB), Hopsworks(RonDB) |
| 레지스트리 | 피처 정의·소유자·버전·엔티티 | Feature Group 메타데이터 | Feast Registry(YAML/Protobuf) |
| 머티리얼라이제이션 | 오프라인→온라인 동기화 | 스트리밍 적재 | Feast materialize, Flink 잡 |
핵심 개념:
- Point-in-time correctness: 학습 샘플의 이벤트 시각 기준으로 “그 시점에 알 수 있었던” 피처 값만 조인한다. 미래 정보 누수(Leakage) 방지.
- Training-Serving Skew: 학습 시 피처 계산 로직과 서빙 시 로직이 다르면 성능 저하. 해결: 동일 피처 정의를 한 곳(레지스트리)에서 선언하고 오프라인·온라인 모두 그 정의로 생성.
- 선택 기준: 모델 수가 적고 배치 추론만 있으면 Feature Store 없이 Iceberg 테이블 + SQL로 충분. 온라인 추론·다수 모델·피처 재사용이 있을 때 도입.
-- point-in-time 조인 (ASOF 의미) 예시: 청구 시점 이전의 최신 고객 피처만 사용
SELECT c.claim_id, c.claim_ts, f.*
FROM silver.claim c
JOIN feature.customer_daily f
  ON f.customer_id = c.customer_id
 AND f.feature_ts = (
   SELECT MAX(feature_ts) FROM feature.customer_daily
   WHERE customer_id = c.customer_id AND feature_ts <= c.claim_ts);
3.6 학습 데이터셋 버저닝
| 방식 | 도구 | 장점 | 한계 |
|---|---|---|---|
| 테이블 스냅샷/태그 | Iceberg snapshot tag/branch, Delta version |
추가 도구 없음, SQL로 재현 | 비정형 파일 자체는 별도 |
| 파일 수준 버전 | lakeFS(Git 방식 브랜치), DVC, S3 버전 관리 | 비정형·모델·코드 함께 커밋 | 운영 컴포넌트 추가 |
| 실험 추적 연결 | MLflow/SageMaker Experiments에 데이터 버전 ID 기록 | 모델↔데이터 매핑 | 데이터 자체 버전은 위 두 방식 필요 |
권고: Iceberg 태그(train_2026q3_v2)를 데이터셋 ID로 삼고 MLflow 런에 기록. 비정형 코퍼스는 lakeFS 또는 S3 버전+매니페스트(JSON 목록)로 고정.
▶ 포인트
- "Silver=Vault/3NF(진실), Gold=Kimball/OBT(서빙)"처럼 계층별로 모델링 기법을 배치.
- SCD2와 point-in-time 조인을 "재현성·누수 방지"라는 하나의 원리로 묶어 설명하라.
- Feature Store는 도입하지 않을 조건도 말해야 한다(배치 전용·소수 모델).
- 트레이드오프: 정규화(정합성·갱신 용이) vs 비정규화(조회 성능·LLM 친화) — 양쪽을 재생성 가능한 파생 관계로 묶어 해소.
4. 비정형·반정형 데이터 구조
4.1 데이터 유형별 구조 특성
| 유형 | 예(보험) | 전처리 핵심 | 저장 구조 | 주의 |
|---|---|---|---|---|
| 문서(PDF/HWP/DOCX) | 약관, 청구서, 심사 보고서, 규정 | 레이아웃 보존 파싱, 표·각주 추출 | 원본(S3) + 파싱 결과(JSON) + 청크 테이블 | 스캔본 OCR 품질, 표 구조 손실 |
| 이미지 | 사고 사진, 진단서 스캔, 신분증 | OCR, 객체 검출, 캡셔닝 | 원본 + 캡션/태그 + 이미지 임베딩 | 민감정보(신분증) 마스킹 |
| 음성 | 콜센터 녹취 | STT, 화자 분리, 요약 | 원본 + 전사(세그먼트별 타임스탬프) + 임베딩 | 통화 동의·보존 기간 |
| 로그/이벤트 | 앱 로그, 거래 이벤트 | 스키마 추론, 세션화 | JSON → Iceberg VARIANT/구조화 컬럼 | 스키마 드리프트 |
| 반정형(JSON/XML) | 외부 API 응답, 전자문서 | 평탄화 vs VARIANT 보존 | Bronze 원본, Silver 구조화 | 중첩 깊이·배열 폭발 |
4.2 Document AI / IDP 파이프라인
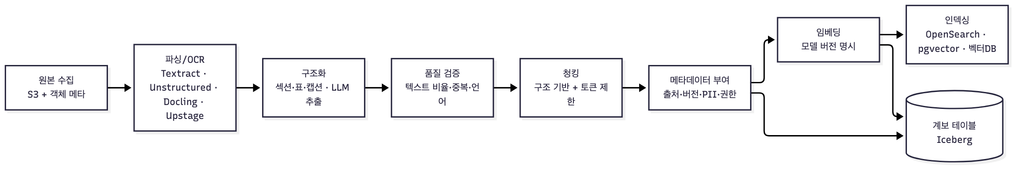
단계별 설계 판단:
- 파싱: 관리형(Amazon Textract, Bedrock Data Automation) vs 오픈소스(Unstructured, Docling, PyMuPDF, Tesseract) vs 국내 특화(한국어 문서·HWP 대응 OCR). 판단 기준은 한국어·표·스캔 품질과 망 환경(외부 API 호출 허용 여부 → 7.7).
- 구조화: 표는 마크다운/HTML로 직렬화하여 청크에 포함, 각주·조항 번호는 메타데이터로 승격(약관 “제12조 제3항” 같은 인용 가능성 확보).
- 청킹: 아래 4.3.
- 메타데이터: 검색 필터·권한·인용·재임베딩을 위해 스키마화(4.4).
- 임베딩·인덱싱 세부: → 02장.
4.3 청킹 전략 선택
| 전략 | 방법 | 적합 | 트레이드오프 |
|---|---|---|---|
| 고정 길이 + 오버랩 | N 토큰, 10~20% 중첩 | 균질한 텍스트, 빠른 구축 | 문맥 절단 |
| 구조 기반(제목/조항/표) | 문서 구조 단위로 분할 | 약관·규정·매뉴얼 | 파서 품질 의존 |
| 의미 기반(Semantic) | 임베딩 유사도 변화점에서 분할 | 긴 서술문 | 비용 높음 |
| 계층(부모-자식) | 작은 청크로 검색, 큰 부모로 생성 | 정확도·문맥 양립 | 저장 2배, 복잡도 |
| 문서 요약 + 청크 | 문서 수준 요약을 별도 청크로 | 문서 선택 단계가 필요한 대형 코퍼스 | 요약 비용 |
4.4 청크 메타데이터 스키마 예시
{
  "chunk_id": "doc_7f3a...#p12#c03",
  "doc_id": "doc_7f3a...",
  "doc_version": "2026-03-01T00:00:00Z",
  "source_uri": "s3://ins-raw/terms/장기보험약관_v12.pdf",
  "source_system": "DMS",
  "content_sha256": "9c1e...",
  "page_start": 12, "page_end": 12,
  "section_path": ["제3장 보험금의 지급", "제12조", "제3항"],
  "chunk_index": 3, "parent_chunk_id": "doc_7f3a...#p12",
  "lang": "ko", "token_count": 412,
  "doc_type": "policy_terms", "product_code": "LT-2024-001",
  "effective_from": "2024-04-01", "effective_to": null,
  "pii_level": "none", "acl": ["grp:claims", "grp:underwriting"],
  "embedding": {"model": "amazon.titan-embed-text-v2", "dim": 1024, "version": "v2"},
  "created_at": "2026-09-30T10:00:00Z", "pipeline_run_id": "prefect-run-9a2"
}
설계 원칙: ① doc_id+doc_version+content_sha256로 중복·변경 감지, ② section_path로 인용 가능성, ③ effective_from/to로 유효 시점 기준(point-in-time) 검색(구 약관 vs 신 약관), ④ acl로 검색 시 권한 필터(사전 필터링), ⑤ embedding.model/version으로 재임베딩 대상 식별.
4.5 원본-청크-임베딩 계보(Lineage) 유지
| 테이블 | 키 | 주요 컬럼 | 목적 |
|---|---|---|---|
doc_registry |
doc_id, doc_version | source_uri, sha256, parsed_uri, status | 원본 등록·버전 |
chunk |
chunk_id | doc_id, doc_version, text, section_path, meta | 청크 본문·메타 |
embedding |
chunk_id, model_version | vector_ref(index 이름/ID), created_at | 모델별 임베딩 추적 |
index_membership |
index_name, chunk_id | 적재 시각, 상태 | 어떤 인덱스에 어떤 청크가 있는지 |
이 네 테이블을 Iceberg로 두면 "이 답변의 근거 청크가 어떤 원본 어느 버전에서 왔는가"를 SQL로 추적하고, 원본 삭제 요청 시 청크·임베딩·인덱스 항목을 연쇄 삭제(Cascade)할 수 있다. 인덱스 자체(OpenSearch)는 서빙 사본으로 취급하고 진실은 레이크하우스에 둔다.
4.6 재임베딩(Re-embedding) 전략
| 트리거 | 범위 | 전략 |
|---|---|---|
| 임베딩 모델 교체 | 전체 | 신규 인덱스 병렬 구축(Blue/Green) → 평가(→ 02장) → 별칭(alias) 전환 → 구 인덱스 보존 후 삭제 |
| 문서 갱신 | 해당 doc_version | sha256 비교로 변경 청크만 재임베딩, 구 버전 청크는 effective_to 설정 |
| 청킹 전략 변경 | 전체 또는 문서 유형별 | 문서 유형별 점진 전환, A/B 평가 |
| 품질 이슈 | 특정 섹션 | 수동 재처리 큐 |
비용 통제: 임베딩 호출 수·토큰 비용을 pipeline_run_id 단위로 기록하고, 전체 재임베딩은 분기 단위 예산으로 관리.
4.7 멀티모달 저장 구조
- 원본은 객체 스토리지(S3 Standard → Intelligent-Tiering), 메타데이터·전사·캡션은 Iceberg, 임베딩은 모달리티별 인덱스(텍스트/이미지 공동 임베딩 모델 사용 시 동일 인덱스, 아니면 별도 인덱스 + 결과 융합).
- 녹취:
call_id→ 세그먼트(화자, 시작/종료 초) → 텍스트 청크. 타임스탬프를 메타데이터로 보존해 "근거 구간 재생"을 가능하게 한다. - 이미지: 캡션·OCR 텍스트를 텍스트 인덱스에, 이미지 임베딩을 별도 k-NN 필드에. 신분증·진단서는 마스킹된 파생본만 인덱싱.
▶ 포인트
- IDP 파이프라인은 "파싱→구조화→청킹→메타데이터→임베딩→인덱싱"의 6단계와 각 단계의 선택 기준을 적어야 한다.
- 메타데이터 스키마에 버전·유효기간·권한·임베딩 모델이 들어있는지가 채점 포인트.
- 계보 테이블로 삭제 연쇄·근거 추적이 가능함을 명시하고, 인덱스는 재생성 가능한 사본임을 강조.
- 트레이드오프: 청크 크기(정확도 vs 문맥), 관리형 파서(속도·운영 ↓) vs 자체 파서(한국어·망 제약 대응).
5. 시맨틱 레이어·메타데이터·온톨로지·지식 그래프
5.1 메타데이터의 네 가지 유형
| 유형 | 내용 | 예 |
|---|---|---|
| 기술 메타데이터 | 스키마, 타입, 파티션, 통계 | Iceberg 메타데이터, Glue 테이블 정의 |
| 비즈니스 메타데이터 | 용어 정의, 소유자, 민감도, 지표 정의 | "유효계약"의 정의, 데이터 소유 부서 |
| 운영 메타데이터 | 파이프라인 실행, 신선도, 품질 결과 | Prefect 런 상태, 품질 점수 |
| 소셜/사용 메타데이터 | 조회 빈도, 질의 패턴, 평가 | 가장 많이 조인되는 테이블, 사용자 평점 |
AI 관점에서는 이 네 유형을 기계가 읽을 수 있는 형태(API/그래프)로 노출하는 것이 핵심이다. 에이전트는 사람이 읽는 위키가 아니라 카탈로그 API를 호출한다.
5.2 데이터 카탈로그 비교
| 카탈로그 | 성격 | 강점 | 한계 | 선택 시점 |
|---|---|---|---|---|
| DataHub | 오픈소스(LinkedIn), 푸시 기반 메타데이터 그래프, Kafka 백본 | 리니지·컬럼 수준, 풍부한 커넥터, 액션 프레임워크 | 운영 복잡(Kafka·ES·MySQL) | 대규모·다양한 소스, 자체 운영 역량 |
| OpenMetadata | 오픈소스, 단일 API·스키마 중심 | 설치 단순, 품질·거버넌스 내장, UI 완성도 | 그래프 기반 확장성은 DataHub 대비 제한적 | 중규모, 빠른 도입 |
| Amundsen | 오픈소스(Lyft), 검색·발견 중심 | 단순 | 리니지·거버넌스 기능 제한, 커뮤니티 축소 | 신규 도입 비권장 |
| Amazon DataZone → SageMaker Catalog | 관리형, 도메인·프로젝트·구독 승인 워크플로 | Lake Formation 권한 연동, 생성형 AI 메타 자동 생성, Mesh 운영에 적합 | AWS 외부 자산 커버리지 | AWS 중심 Data Mesh |
| Collibra / Alation / Atlan | 상용 거버넌스 플랫폼 | 정책·워크플로·규제 대응 | 비용 | 규제 중심 대기업 |
5.3 리니지(Lineage)
- 표준: OpenLineage(이벤트 스펙) + Marquez(레퍼런스 서버). Spark/Airflow/dbt/Flink/Prefect 통합으로 잡 실행 시 입력·출력 데이터셋을 자동 수집.
- 수준: 테이블 수준(필수) → 컬럼 수준(권장, 영향 분석·PII 전파 추적) → 행 수준(Iceberg v3 row lineage로 CDC·감사).
- AI 확장: 모델·임베딩 인덱스·프롬프트 템플릿도 리니지 노드로 등록해 "데이터 변경 → 어떤 모델/인덱스 재생성 필요"를 자동 판단.
5.4 시맨틱 레이어와 Text-to-SQL
| 솔루션 | 형태 | 강점 | 한계 |
|---|---|---|---|
| dbt Semantic Layer(MetricFlow) | dbt 모델 위 메트릭·차원 YAML, API로 질의 | dbt 자산과 일체, 버전 관리 | dbt Cloud 의존(2025년 dbt Labs–Fivetran 합병, 2026년 완료; dbt Core는 오픈 유지 선언) |
| Cube | 독립 시맨틱 레이어 + 캐시 + REST/SQL/GraphQL API | 엔진 중립, AI API(Agent용) 제공 | 별도 운영 |
| AtScale | 가상 큐브, 다차원 모델 | 대규모 BI, 복잡 집계 | 상용 |
| AWS 네이티브 | Amazon Q in QuickSight 토픽, Redshift/Athena 뷰 + Glue 비즈니스 메타 | 관리형 | 벤더 종속, 중립 메트릭 정의 부재 |
LLM 활용 원리: LLM이 물리 테이블을 직접 조인하게 하지 말고 시맨틱 레이어의 메트릭·차원 정의를 도구(API)로 제공한다. 이렇게 하면 ① 지표 정의가 사람·BI·LLM 간에 하나로 통일되고, ② 권한·행 필터가 레이어에서 강제되며, ③ 환각(존재하지 않는 컬럼 조인)이 구조적으로 차단된다.
# 시맨틱 레이어 메트릭 정의 예시 (dbt MetricFlow 스타일)
semantic_models:
  - name: claims
    model: ref('fct_claim')
    entities: [{name: claim, type: primary, expr: claim_id},
               {name: policy, type: foreign, expr: policy_id}]
    dimensions: [{name: claim_date, type: time, type_params: {time_granularity: day}},
                 {name: product_line, type: categorical}]
    measures: [{name: paid_amount, agg: sum},
               {name: claim_count, agg: count_distinct, expr: claim_id}]
metrics:
  - name: loss_ratio
    type: ratio
    type_params: {numerator: paid_amount, denominator: earned_premium}
5.5 온톨로지(Ontology): OWL / RDF / SKOS — 보험 도메인 예시
| 표준 | 역할 | 보험 예 |
|---|---|---|
| RDF | 주어-술어-목적어 트리플 데이터 모델 | :policy123 :hasCoverage :cov_fire |
| RDFS/OWL | 클래스·속성·제약·추론 규칙 | Rider ⊑ Coverage, hasInsured 역속성, 카디널리티 |
| SKOS | 용어집·분류 체계(상위/하위/동의어) | 상품 분류, 질병 코드 매핑(KCD), 사고 유형 |
| SHACL | 그래프 제약 검증 | “청구는 반드시 하나의 계약과 연결” |
@prefix ins: <https://example.co.kr/ontology/insurance#> .
ins:Policy a owl:Class .  ins:Coverage a owl:Class .  ins:Claim a owl:Class .
ins:Rider rdfs:subClassOf ins:Coverage .
ins:hasCoverage a owl:ObjectProperty ; rdfs:domain ins:Policy ; rdfs:range ins:Coverage .
ins:claimsOn    a owl:ObjectProperty ; rdfs:domain ins:Claim  ; rdfs:range ins:Policy .
ins:Policyholder rdfs:subClassOf ins:Party .  ins:Insured rdfs:subClassOf ins:Party .
엔티티 핵심 세트: 당사자(계약자/피보험자/수익자) – 상품 – 계약 – 담보/특약 – 사고(이벤트) – 청구 – 지급 – 설계사/채널 – 언더라이팅 결정. 온톨로지는 “동일 개념의 다른 이름”(예: 코어 시스템의 CONT_NO와 CRM의 policy_number)을 하나의 개념에 매핑하는 의미 통합 계약서 역할을 한다.
5.6 지식 그래프가 AI에 주는 가치
| 가치 | 설명 | 구현(AWS / 중립) |
|---|---|---|
| 엔티티 해소(Entity Resolution) | 고객·사업자·사고의 중복을 식별·통합 | Neptune + AWS Entity Resolution / Neo4j + Senzing |
| 다중 홉 추론 | “이 청구의 계약자가 최근 3년 내 동일 사고 유형으로 다른 보험사에 청구했는가” | Gremlin/openCypher 순회, SPARQL |
| GraphRAG 기반 | 청크를 엔티티·관계로 연결해 벡터 검색의 문맥 단절 보완 | Bedrock Knowledge Bases GraphRAG(Neptune Analytics, 2025년 3월 GA) / LightRAG, Microsoft GraphRAG + Neo4j |
| 설명 가능성 | 답변 근거를 경로로 제시 | 경로 반환 API |
| 사기 탐지·네트워크 분석 | 공모 패턴, 커뮤니티 탐지 | Neptune Analytics 알고리즘 / Neo4j GDS |
선택 기준: 질문이 "관계·경로·네트워크"를 요구하면 그래프, "유사 문서"면 벡터, 둘 다면 하이브리드(→ 02장). 비선택: 단순 조회·집계는 RDB/DW가 더 싸고 빠르다. 트레이드오프: 그래프 구축·유지(엔티티 추출 품질, 온톨로지 관리) 비용 vs 추론 능력.
▶ 포인트
- 카탈로그는 "발견"이 아니라 "기계 판독 가능한 메타데이터 API"로 정의하고, 에이전트/Text-to-SQL이 그것을 소비한다고 써라.
- 시맨틱 레이어 도입 근거 3가지(지표 통일·권한 강제·환각 차단)를 외워라.
- 온톨로지는 보험 엔티티로 구체화하고 SKOS(용어)·OWL(클래스/관계)·SHACL(검증)의 역할 분담을 말하라.
- 트레이드오프: 그래프 구축 비용 vs 다중 홉·설명 가능성; 카탈로그 자체 운영(DataHub) vs 관리형(SageMaker Catalog).
6. 저장·서빙 계층 선택 (Polyglot Persistence)
6.1 저장소 유형별 특성
| 유형 | 워크로드 | 일관성 | 지연 | 비용 특성 | AWS | 오픈소스/중립 |
|---|---|---|---|---|---|---|
| OLTP RDB | 트랜잭션, 정합성 | 강한 ACID | ms | 인스턴스/IOPS | Aurora, RDS | PostgreSQL, MySQL |
| OLAP DW(컬럼형) | 대규모 집계·조인 | 스냅샷 | 초~분 | 컴퓨트 시간/스캔량 | Redshift, Athena(레이크하우스 질의) | Trino, ClickHouse, StarRocks, DuckDB |
| 검색 엔진 | 전문(BM25)·필터·집계·하이브리드 | 근실시간(refresh) | 수십 ms | 노드/스토리지 | OpenSearch Service/Serverless | OpenSearch, Elasticsearch |
| 벡터 DB | ANN 검색, 메타 필터 | 최종적 | ms~수십 ms | 메모리(HNSW) | OpenSearch k-NN, Aurora pgvector, (S3 Vectors — GA 여부 확인 필요) | pgvector, Qdrant, Milvus, Weaviate, Chroma |
| 그래프 DB | 관계 순회·패턴 | 트랜잭션(Neptune) | ms~초 | 인스턴스/그래프 크기 | Neptune, Neptune Analytics | Neo4j, JanusGraph, ArangoDB |
| KV·캐시 | 키 조회, 세션, 온라인 피처 | 최종적/강한(설정) | sub-ms~ms | 메모리/RCU | DynamoDB, ElastiCache | Redis, Valkey, Cassandra |
| 객체 스토리지 | 원본·테이블 파일·모델 아티팩트 | 강한 쓰기 후 읽기(read-after-write) 일관성 | 수십 ms(첫 바이트) | GB당 저렴 | S3 | MinIO, Ceph |
6.2 선택 매트릭스
| 질문 | 예 | → 저장소 |
|---|---|---|
| 한 트랜잭션에서 여러 행을 원자적으로 갱신하는가 | 계약 체결·보험료 수납 | OLTP RDB |
| 수십억 행을 스캔·집계하는가 | 손해율 분석, 규제 리포팅 | 레이크하우스 + DW/쿼리 엔진 |
| 키워드·필터·유사도를 섞어 찾는가 | 약관 검색, 상담 지식 | 검색 엔진(+벡터) |
| 벡터 수와 QPS가 매우 크고 순수 ANN만 필요한가 | 수억 벡터 추천 | 전용 벡터 DB |
| 관계의 깊이가 질문의 핵심인가 | 사기 네트워크, 다중 홉 | 그래프 DB |
| 단일 키로 1ms 내 응답해야 하는가 | 온라인 피처, 세션, 시맨틱 캐시 | KV/캐시 |
| 재생성 가능한 대용량 바이너리인가 | 원본 문서, 모델 | 객체 스토리지 |
판단 축 5개를 명시: 워크로드 패턴 · 일관성 요구 · 지연 목표 · 비용 모델 · 운영 역량. "하나의 DB로 다 한다"는 답은 감점, "질문 유형마다 다른 저장소"는 가점이되 동기화·일관성 비용을 함께 적어야 한다.
6.3 “벡터 전용 DB vs 기존 DB의 벡터 확장” 논쟁 정리
| 관점 | 기존 DB 확장(pgvector, OpenSearch k-NN) | 전용 벡터 DB(Qdrant, Milvus, Pinecone, Weaviate) |
|---|---|---|
| 데이터 수 | 수백만~수천만 벡터까지 실용(HNSW, 메모리 충분 시) | 수억 이상, 샤딩·분산 내장 |
| 기능 | 트랜잭션·조인·BM25 하이브리드·권한을 한곳에서 | 필터링·양자화·멀티테넌시 등 벡터 특화 최적화 |
| 운영 | 이미 운영 중인 시스템 재사용, 팀 역량 재활용 | 신규 컴포넌트, 동기화 파이프라인 추가 |
| 일관성 | 원본과 벡터가 같은 트랜잭션 경계(pgvector) | 최종적 일관성, 원본과 드리프트 가능 |
| 비용 | 기존 인스턴스 메모리 증설 | 별도 클러스터/서비스 비용 |
| 2026년 업계 권고 | “이미 운영하는 DB부터 시작, 병목을 구체적으로 특정할 수 있을 때 전환” | 대규모 벡터·높은 QPS·복잡 필터·일관된 저지연 요구 시 |
금융권 추가 고려: 망 환경에서 SaaS 벡터 DB(Pinecone 등)는 제약이 크므로, 내부망 구축 가능한 OpenSearch/pgvector/Milvus/Qdrant가 현실적 후보다. OpenSearch는 하이브리드(BM25+k-NN)·권한(문서 수준 보안)·집계를 한 번에 제공하여 검색 중심 RAG에 유리하고, 순수 벡터 처리량은 전용 DB 대비 다소 낮다(→ 02장).
6.4 보험사 예시: Polyglot 매핑
| 도메인 자산 | 1차 저장소 | 파생/서빙 사본 | 동기화 |
|---|---|---|---|
| 계약·청구 원장 | Aurora PostgreSQL | Iceberg(Silver/Gold), OpenSearch(조회용), DynamoDB(온라인 피처) | CDC(Debezium/DMS) |
| 약관·심사 문서 | S3 원본 + Iceberg 메타 | OpenSearch 하이브리드 인덱스 | IDP 파이프라인 |
| 고객·사고 네트워크 | Iceberg(Silver) | Neptune(그래프 투영) | 배치/스트리밍 투영 |
| 지표·리포트 | Iceberg Gold | Redshift/Athena + 시맨틱 레이어 | 배치 |
| 세션·캐시 | ElastiCache/Redis | — | 앱 |
▶ 포인트
- 5개 판단 축(워크로드·일관성·지연·비용·운영)을 표로 제시하고 각 자산을 매핑하라.
- Polyglot의 대가는 "동기화와 단일 진실"이다 — CDC와 레이크하우스를 진실의 원천으로 두는 구조로 해소.
- 벡터 DB 논쟁은 "기존 DB부터, 병목 특정 후 전환"이라는 결론과 금융 망 제약을 함께 쓰라.
- 트레이드오프: 단일 저장소(단순·일관) vs 다중 저장소(최적 성능·복잡도).
7. 데이터 거버넌스·품질·보안
7.1 데이터 컨트랙트(Data Contract)
데이터 컨트랙트는 생산자–소비자 간 스키마·품질·SLA·소유권·용어를 코드로 선언하고 CI에서 검증하는 계약이다. 2026년 기준 벤더 중립 표준은 ODCS(Open Data Contract Standard, Bitol/LF AI & Data, v3.x) 이며, datacontract CLI(MIT)가 ODCS를 네이티브 지원하여 Snowflake/BigQuery/Databricks/Postgres/Kafka/S3 등에 대해 스키마·품질 테스트를 실행하고 25개 이상 포맷으로 내보낸다. Soda Core v4(2026년 1월)도 데이터 컨트랙트를 품질 규칙 정의의 기본 방식으로 전환했다.
# ODCS 스타일 데이터 컨트랙트 (요약)
apiVersion: v3.0.2
kind: DataContract
id: claims.silver.claim
version: 2.1.0
status: active
team: {name: claims-data, owner: claims-de@corp}
schema:
  - name: claim
    properties:
      - {name: claim_id, logicalType: string, required: true, unique: true}
      - {name: policy_id, logicalType: string, required: true}
      - {name: amount, logicalType: number, quality: [{rule: nonNegative}]}
      - {name: customer_rrn, logicalType: string, classification: PII-high,
         transformLogic: "tokenized"}
slaProperties:
  - {property: freshness, value: 15, unit: m}
  - {property: retention, value: 5, unit: y}
선택 기준: 도메인 간 소비 관계가 3개 팀 이상이거나 AI 파이프라인이 Silver를 소비하면 도입. 비선택: 단일 팀 내부 테이블. 트레이드오프: 변경 민첩성 ↓ vs 하위 소비자 장애(Breaking Change) 사전 차단.
7.2 스키마 레지스트리
- 스트리밍 경계의 컨트랙트: Confluent Schema Registry / Apicurio / AWS Glue Schema Registry. Avro/Protobuf/JSON Schema에 호환성 모드(BACKWARD/FORWARD/FULL)를 설정하여 생산자 변경을 통제.
- 설계 규칙: 필드 추가는 기본값 필수, 삭제는 두 단계(deprecate → remove), 타입 변경 금지. 레이크하우스 스키마 진화 정책과 일치시킨다.
7.3 데이터 품질 프레임워크 (2026년 지형 반영)
| 프레임워크 | 형태 | 강점 | 2026년 상태 | 선택 시점 |
|---|---|---|---|---|
| Great Expectations(GX Core) | Python, Expectation 선언 | 풍부한 검증, 문서 자동화 | GX Cloud는 FICO에 인수(2026년 5월 발표, 6월 1일 공개 서비스 종료), GX Core는 Fivetran이 스튜어드로 오픈소스 유지 | Python 중심 팀, 세밀 검증 |
| Soda Core | YAML(SodaCL/컨트랙트) | 경량, SQL 소스 친화, 컨트랙트 중심 | v4(2026년 1월)에서 컨트랙트 중심으로 전환, 라이선스 Apache 2.0 → Elastic License 2.0(내부 사용 무료, 서비스 재판매 제한) | SQL 중심, 컨트랙트 통합 |
| Deequ / PyDeequ | Spark 라이브러리(AWS) | 대규모 Spark 배치에 내장, 제약 추천 | AWS Glue Data Quality의 기반(DQDL) | Spark/Glue 파이프라인 |
| AWS Glue Data Quality | 관리형, DQDL 규칙 | Glue/카탈로그 통합, 이상 탐지 | — | AWS 네이티브 |
판단: 품질 검사는 Bronze→Silver 경계(컨트랙트 검증) 와 Silver→Gold/Feature/Chunk 경계(비즈니스 규칙) 두 곳에 배치. 실패 시 격리(Quarantine) 테이블로 분기하고 파이프라인을 중단할지(Fail-closed) 경고만 할지(Fail-open)를 데이터 중요도별로 정한다.
7.4 데이터 관측성(Observability) 5대 축
| 축 | 측정 | 도구 |
|---|---|---|
| 신선도(Freshness) | 마지막 갱신 시각 대비 SLA | Monte Carlo, elementary, Glue DQ, 자체 메트릭 |
| 볼륨(Volume) | 행 수·파일 수 급변 | 통계 이상 탐지 |
| 스키마(Schema) | 컬럼 추가/삭제/타입 변경 | 레지스트리·카탈로그 diff |
| 분포(Distribution) | NULL 비율, 범주 분포, 통계 드리프트 | Deequ 프로파일, Evidently |
| 리니지(Lineage) | 영향 범위, 근본 원인 | OpenLineage/DataHub |
AI 확장: 임베딩 인덱스 신선도(원본 대비 지연), 청크 수 변화, 임베딩 분포 드리프트(→ 8.5)를 동일 프레임에 추가한다.
7.5 PII 분류·마스킹·토큰화
| 기법 | 가역성 | 용도 | 예 |
|---|---|---|---|
| 마스킹(Masking) | 비가역 | 표시·분석 | 주민번호 뒤 7자리 * |
| 가명처리(Pseudonymization) | 키 보유자만 복원 | 분석·결합(신용정보법 가명정보) | 해시+솔트, 토큰 |
| 토큰화(Tokenization) | 볼트(Vault) 통해 복원 | 운영 시스템 간 전달 | 포맷 보존 토큰 |
| 익명처리(Anonymization) | 비가역 | 외부 제공 | k-익명성, 일반화 |
| 암호화(Encryption) | 키로 복원 | 저장·전송 | KMS 봉투 암호화, 컬럼 암호화 |
| 차등 프라이버시/합성 데이터 | 비가역 | 모델 학습·테스트 | → 8.3 |
탐지 도구: Amazon Macie(S3 PII 스캔), Amazon Comprehend(텍스트 PII), Glue 민감 데이터 탐지 / 오픈소스 Microsoft Presidio. 분류 결과는 카탈로그 태그(pii_level)로 등록하고 접근 정책이 태그를 참조하게 한다(태그 기반 접근제어, TBAC). 비정형 문서는 청킹 전에 PII 탐지·마스킹을 적용한 파생본만 인덱싱한다.
7.6 행/열 수준 접근제어
- AWS Lake Formation: 데이터 필터로 행(Row Filter)·열(Column)·셀(Cell) 수준 권한, 태그 기반 LF-Tags, Athena/Redshift/EMR/SageMaker에 일관 적용. Glue 카탈로그·DataZone/SageMaker Catalog 구독 승인과 연동.
- 중립: Apache Ranger(Hive/Trino/Kafka 정책), Trino 행 필터·컬럼 마스킹, Unity Catalog 행 필터/컬럼 마스크, Polaris RBAC, OpenSearch 문서/필드 수준 보안.
- RAG 고유 고려사항: 벡터 검색은 "검색 후 필터"가 아닌 “검색 전 ACL 필터”(인덱스 메타
acl필드)로 설계해야 권한 밖 문서가 top-k에 섞이지 않는다(→ 02장).
7.7 한국 금융권 규제 맥락 (검색 확인, 2026년 10월 기준)
| 법·규정 | 핵심 요구 | 데이터 구조에의 영향 |
|---|---|---|
| 개인정보보호법 | 수집 최소화, 목적 외 이용 제한, 가명처리 특례, 자동화된 결정 대응권(2023년 개정), 국외 이전 요건 | PII 분류·태깅, 목적별 접근 정책, 모델 결정 설명 로그, 리전·국외 전송 통제 |
| 신용정보법 | 개인신용정보 처리·가명정보 결합(데이터전문기관), 마이데이터, 정보 전송 요구권 | 가명정보 처리 환경 분리, 결합 키 관리, 동의 메타데이터 |
| 전자금융감독규정 | 망분리, 클라우드 이용 절차(중요도 평가·CSP 안전성 평가), 정보처리 위탁 | 내부망/외부망 간 데이터 흐름 설계, 리전 내 처리, 위탁 리스크 관리 |
| 개인정보위 「생성형 AI 개발·활용을 위한 개인정보 처리 안내서」(2025년 8월 6일) | 생성형 AI 수명주기(목적 설정→전략→학습·개발→적용·관리)별 개인정보 기준, 비정형데이터·공개 정보·합성데이터 기준 | 학습 데이터 출처·적법 근거 메타데이터, 비정형 가명처리 절차 |
망분리 완화 흐름(금융위원회 「금융분야 망분리 개선 로드맵」, 2024년 8월 13일 발표):
- 1단계(2024년~): 규제샌드박스를 통해 ① 생성형 AI가 가명처리된 개인신용정보까지 처리하도록 허용(내부 시스템–외부 AI 모델 간 망분리 특례, 강화된 보안대책·금감원 보안점검 조건), ② SaaS 이용 범위를 보안관리·CRM·가명정보 처리·모바일 단말까지 확대, ③ 연구·개발망과 업무망 간 논리적 망분리 허용.
- 2단계: 1단계 특례의 효용성·보안 검증 후 규정 개정으로 상시 제도화, 가명정보가 아닌 개인신용정보 직접 처리까지 확대(클라우드 처리 시 국내 정보처리시스템 설치 요구), 제3자 리스크(위탁) 관리 강화.
- 3단계: 「디지털금융보안법(가칭)」 제정, 열거식 규칙 → 목표·원칙 중심의 자율보안–결과책임 체계.
- 제도화 진행: 2026년 1월 20일 「전자금융감독규정 시행세칙」 개정안 사전예고 — 일정 보안 요건(금융보안원 평가 ‘충족’, 접근·권한 관리, 중요정보 모니터링, 외부 인터넷 접근 통제, 반기별 자체평가·정보보호위원회 보고)을 충족하는 내부 업무망 SaaS 이용을 망분리 예외로 명시. 단, 개인정보·신용정보를 처리하는 SaaS는 이번 완화에서 제외. (최종 시행 시기·조문은 확인 필요)
- 설계 함의: "외부 LLM API 호출 가능 여부"가 아키텍처를 가른다. 가명정보 한정 외부 호출 + 원문·식별정보는 내부망 보존 + 호출 로그·프롬프트 감사 저장소 + 국내 리전 처리 + 온프레미스/프라이빗 모델 대안을 단계별(현재 가능 / 2단계 제도화 후 가능) 로 나눠 서술
7.8 감사 로그
- 대상: 데이터 접근(쿼리·테이블·컬럼·행 필터 적용 여부), 정책 변경, 파이프라인 실행, 모델 추론 입력/출력(프롬프트·근거 청크·응답), 외부 API 호출.
- 구조: 불변 Append-only(S3 Object Lock, CloudTrail Lake / 중립: Kafka → Iceberg 감사 테이블), 보존 기간은 규정별(전자금융 거래기록 5년 등 — 구체 기간은 규정 확인 필요).
- AI 고유 고려사항: LLM 응답의 근거 청크 ID·임베딩 모델·프롬프트 템플릿 버전을 함께 저장해야 사후 설명이 가능하다.
▶ 포인트
- 거버넌스는 "컨트랙트(사전) – 품질검사(적재 시) – 관측성(사후) – 접근제어(상시) – 감사(사후 증명)"의 시간축으로 구조화하라.
- PII는 "탐지 → 분류 태그 → 태그 기반 정책 → 마스킹 파생본만 AI 노출"의 흐름으로.
- 한국 금융권은 망분리 로드맵의 단계(가명정보 → 개인신용정보 → 자율보안)를 인용하고, 현재 가능/향후 가능을 구분하라.
- 트레이드오프: Fail-closed(신뢰 ↑, 가용성 ↓) vs Fail-open; 외부 LLM(성능·속도) vs 내부 모델(규제·비용); 보존(재현성) vs 삭제 의무.
8. AI-Ready 데이터
8.1 RAG/LLM용 데이터 품질 차원
| 차원 | 문제 | 대응 |
|---|---|---|
| 중복(Duplication) | 동일 약관 여러 버전·사본이 top-k를 점유 | sha256·MinHash 근사 중복 제거, 버전 중 최신만 active |
| 최신성(Recency) | 구 규정이 검색됨 | effective_from/to 메타 + 검색 시 유효기간 필터, 인덱스 신선도 SLA |
| 정규화(Normalization) | 표기 불일치(전각/반각, 약어, 코드) | 전처리 표준화, SKOS 동의어 사전 |
| 출처 신뢰도(Provenance) | 비공식 문서가 공식 규정과 동급 취급 | source_tier(공식/내부/외부) 메타, 랭킹 가중치 |
| 완전성(Completeness) | 표·각주 누락 | 파서 품질 검증(텍스트 비율·표 수), 샘플 검수 |
| 권한 정합성 | 권한 밖 문서 노출 | ACL 메타 + 사전 필터 |
| 독성·편향 | 부적절 내용 학습 | 필터링, 라벨링 |
8.2 라벨링·골든셋(Golden Set)
- 골든셋 = (질문, 기대 답변, 근거 문서/청크 ID, 메타) 튜플. 도메인 전문가 검수가 핵심이며 버전 관리되는 데이터 자산으로 Iceberg/lakeFS에 저장.
- 구성 원칙: 질문 유형(사실/절차/비교/계산), 난이도, 문서 유형별 층화 샘플링, 최소 수백 건; 운영 로그에서 실패 사례를 주기적으로 편입.
- 라벨링 도구: Amazon SageMaker Ground Truth / Label Studio, Argilla. LLM-as-a-judge로 1차 라벨 후 사람 검수.
- 평가 서비스와의 연계(지표·파이프라인) → 02장.
8.3 합성 데이터(Synthetic Data)
| 용도 | 기법 | 주의 |
|---|---|---|
| 테스트·개발 데이터 | 규칙 기반 생성, 스키마 보존 샘플 | 참조 무결성 유지 |
| 희소 클래스 보강(사기 등) | GAN/LLM 생성, SMOTE | 분포 왜곡·누수 |
| 개인정보 회피 | 차등 프라이버시 합성(SDV, Gretel 등) | 재식별 위험 평가 필수, 개인정보위 안내서의 합성데이터 기준 준수 |
| RAG 평가 질문 생성 | LLM으로 문서 기반 QA 생성 | 골든셋과 혼용 금지(검수 전) |
8.4 데이터·모델·임베딩 버전 관리 매트릭스
| 자산 | 버전 식별자 | 저장 | 연결 |
|---|---|---|---|
| 원천 데이터셋 | Iceberg 스냅샷/태그, lakeFS 커밋 | 레이크하우스 | 모델 런에 기록 |
| 피처 정의 | 레지스트리 버전 | Feature Store | 모델 런에 기록 |
| 모델 | MLflow/SageMaker Model Registry 버전 | 아티팩트 스토어 | 데이터·피처 버전 참조 |
| 임베딩 모델·인덱스 | embedding.version, 인덱스 이름(chunks_v3_titan2) |
계보 테이블 | 청크 버전 참조 |
| 프롬프트·체인 | Git 커밋/템플릿 버전 | 코드 저장소 | 감사 로그에 기록 |
| 골든셋·평가 결과 | 데이터셋 태그 + 실행 ID | 레이크하우스 | 모델·인덱스 버전과 조인 |
원칙: 어떤 추론 결과든 “(데이터 버전, 피처 버전, 모델 버전, 인덱스 버전, 프롬프트 버전)” 5-튜플로 재현 가능해야 한다.
8.5 데이터 드리프트 모니터링
| 드리프트 | 의미 | 측정 | 도구 |
|---|---|---|---|
| 입력(공변량) 드리프트 | 피처 분포 변화 | PSI, KS 검정, JS 거리 | SageMaker Model Monitor, Evidently, whylogs, NannyML |
| 개념 드리프트 | X→y 관계 변화 | 지연 라벨 기반 성능 하락 | 동일 |
| 임베딩 드리프트 | 쿼리/문서 임베딩 분포 변화(신규 상품·용어) | 중심 이동, 클러스터 비율 | Evidently(embedding drift), 자체 |
| 검색 품질 드리프트 | Recall@k·답변 정확도 하락 | 골든셋 재평가 | RAG 평가 서비스(→ 02장) |
대응 정책: 임계치 초과 → 알림 → 재학습/재임베딩 큐 → 평가 통과 시 배포. 모니터링 결과도 관측성 테이블로 적재.
8.6 학습 데이터 저작권·개인정보 이슈
- 저작권: 외부 문서(기사·판례·타사 약관)의 학습·인덱싱 허용 범위를 라이선스 메타(
license,usage_scope)로 기록하고, 비허용 자산은 인덱스에서 배제. 생성 결과의 출처 표기. - 개인정보: 학습 데이터에 포함된 개인정보는 가명처리 원칙, 공개된 개인정보 처리 기준(개인정보위 안내서), 정보주체 삭제 요청 시 학습 데이터·인덱스·캐시 연쇄 삭제 절차(머신 언러닝은 현실적으로 어려우므로 재학습 주기·삭제 반영 SLA를 정책화).
- 계약: 외부 모델 API 이용 시 입력 데이터의 학습 활용 금지 조항, 국외 이전 여부 확인.
▶ 포인트
- "AI-Ready"를 품질 7차원 + 골든셋 + 버전 5-튜플 + 드리프트 4유형으로 구조화하면 완결성이 높다.
- 합성 데이터는 장점만 쓰지 말고 재식별·분포 왜곡 리스크와 검증 절차를 반드시 병기.
- 삭제 요청과 학습 데이터의 긴장을 "재학습 주기·삭제 SLA"로 해소하는 정책 문장을 준비하라.
- 트레이드오프: 최신성(잦은 재임베딩, 비용 ↑) vs 안정성; LLM 자동 라벨(속도) vs 사람 검수(신뢰).
9. 스트리밍·CDC 구조
9.1 구성요소 비교
| 역할 | AWS | 오픈소스/중립 | 선택 포인트 |
|---|---|---|---|
| 이벤트 브로커 | Amazon MSK(Kafka), Kinesis Data Streams | Apache Kafka, Redpanda, Apache Pulsar | Kafka 생태계·커넥터·정확히 한 번 필요 → MSK/Kafka; 완전 관리형·단순 → Kinesis |
| CDC 캡처 | AWS DMS(CDC), MSK Connect + Debezium | Debezium(로그 기반), Maxwell | 로그 기반(저부하·삭제 캡처) 우선, 쿼리 기반(타임스탬프)은 삭제 누락 |
| 스트림 처리 | Amazon Managed Service for Apache Flink, EMR Spark Structured Streaming, Glue Streaming | Apache Flink, Spark Structured Streaming, Kafka Streams | 이벤트 시간·상태·정확히 한 번 → Flink; 배치 코드 재사용 → Spark SS |
| 싱크 | Iceberg(S3), OpenSearch, DynamoDB, Redshift(스트리밍 수집) | Iceberg/Delta/Hudi, OpenSearch, Redis | 싱크의 멱등성 지원 여부 |
9.2 Lambda vs Kappa
| 항목 | Lambda | Kappa |
|---|---|---|
| 구조 | 배치 계층 + 속도 계층 + 서빙 병합 | 스트림 단일 계층, 재처리는 로그 재생 |
| 장점 | 배치의 정확성 + 실시간 | 코드 단일화, 운영 단순 |
| 단점 | 로직 이중 구현·불일치 | 로그 장기 보존 비용, 대규모 재처리 시간 |
| 2026년 현실 | 레이크하우스가 서빙 병합을 흡수 → "스트리밍 적재 + 배치 재계산"의 완화된 Lambda | Kafka 계층형 스토리지·Flink로 Kappa 실현 가능 |
| 선택 | 정합성 규제 리포팅이 핵심, 배치 자산 많음 | 이벤트 중심 도메인(로그·거래 이벤트), 재처리 요구 빈번 |
실무 권고: “Kappa 지향, 레이크하우스 보정” — 스트림이 1차 경로이되 Iceberg 테이블이 단일 진실이 되고, 배치 재계산이 필요하면 Iceberg 스냅샷에서 재생성한다.
9.3 CDC → 레이크하우스 → 서빙 패턴
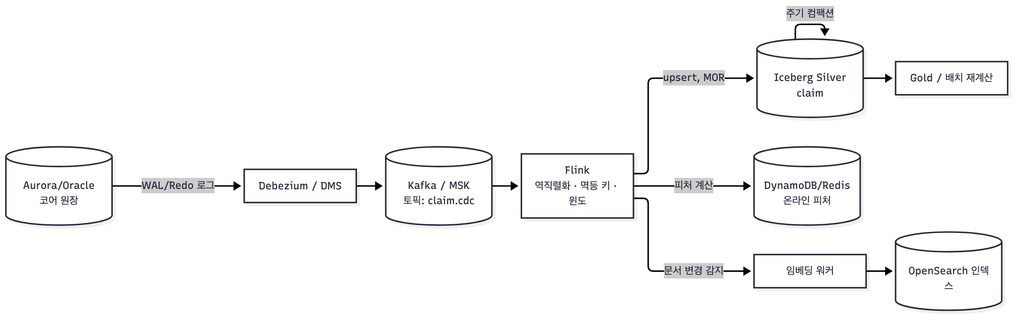
핵심 설계 결정: ① CDC 레코드에 op(c/u/d), ts_ms, lsn을 보존해 순서·멱등 처리, ② Iceberg 쓰기는 MOR + 주기 컴팩션, ③ 온라인 피처는 "최신 상태"만 유지(TTL), ④ 문서 변경 CDC는 임베딩 워커로 분기해 인덱스 증분 갱신.
9.4 실시간 피처·임베딩 갱신 패턴
| 패턴 | 설명 | 지연 | 비용·리스크 |
|---|---|---|---|
| 스트리밍 피처 | Flink 윈도우 집계(최근 1시간 청구 건수) → 온라인 스토어 | 초 | 상태 크기 관리, 늦은 이벤트 처리(워터마크) |
| 요청 시 계산(On-demand) | 추론 시점에 원본 조회·계산 | ms~수십 ms | 서빙 지연 증가, 학습-서빙 일치 유지 쉬움 |
| 마이크로배치 임베딩 | 변경 문서 5~15분 단위 재임베딩 | 분 | 임베딩 호출 비용, 인덱스 refresh 조정 |
| 실시간 임베딩 | 변경 즉시 임베딩·업서트 | 초 | 호출 급증, 모델 레이트리밋 |
| 시맨틱 캐시 무효화 | 원본 변경 시 캐시 키 삭제 | 즉시 | 과도 무효화 시 캐시 효과 소실 |
9.5 Exactly-once와 멱등성
- Kafka: 멱등 프로듀서 + 트랜잭션(read-process-write)으로 토픽 간 정확히 한 번. Flink: 체크포인트 + 2단계 커밋 싱크(Iceberg 싱크는 체크포인트 단위 커밋). Kinesis: 기본 at-least-once → 소비자 측 멱등성 필수.
- 싱크 멱등성: 비즈니스 키 + 버전(LSN/ts) 기반
MERGE INTO, 최신 버전만 반영(Out-of-order 방어). 외부 API(임베딩) 호출은chunk_id+model_version키로 중복 호출 방지. - 현실 원칙: "엔드투엔드 정확히 한 번"은 전 구간이 트랜잭션 싱크일 때만 성립하므로, “at-least-once 전달 + 멱등 소비” 를 기본 설계로 쓰고 exactly-once는 가능한 구간(Kafka↔Flink↔Iceberg)에 한정해 보장한다.
-- 멱등 업서트: 늦게 도착한 구버전 레코드는 무시
MERGE INTO lh.silver.claim t
USING staging.claim_cdc s ON t.claim_id = s.claim_id
WHEN MATCHED AND s.src_lsn > t.src_lsn AND s.op = 'd' THEN DELETE
WHEN MATCHED AND s.src_lsn > t.src_lsn THEN UPDATE SET *
WHEN NOT MATCHED AND s.op <> 'd' THEN INSERT *;
▶ 포인트
- 로그 기반 CDC(삭제 캡처·저부하)를 쿼리 기반 대비 근거로 선택하고, 브로커 선택 근거(생태계 vs 관리 편의)를 명시.
- Lambda/Kappa는 "레이크하우스가 서빙 병합을 흡수한다"는 2026년 관점으로 재해석해 답하라.
- 정확히 한 번은 구간 한정 주장 + 멱등 소비 설계로 안전하게.
- 트레이드오프: 실시간성(비용·복잡도 ↑) vs 마이크로배치(지연 ↑); 상태 크기 vs 윈도우 길이.
10. 설계 체크리스트
(a) 설계 시 반드시 언급할 항목 체크리스트
| # | 항목 | 확인 질문 |
|---|---|---|
| 1 | 요구사항·제약 | 워크로드 유형(배치/실시간/검색/학습), 규제(망분리·개인정보), SLA, 예산, 인력 |
| 2 | 데이터 유형 범위 | 정형/반정형/비정형/벡터/그래프 각각의 수집·저장 경로 |
| 3 | 단일 진실 원천 | 레이크하우스(Iceberg)가 진실, 나머지는 재생성 가능한 서빙 사본인가 |
| 4 | 테이블 포맷·카탈로그 | Iceberg + REST/Glue 연합; 종속 지점(카탈로그) 완화책 |
| 5 | 계층 구조 | Bronze/Silver/Gold + Feature/Chunk, 계층별 책임·금지 |
| 6 | 모델링 | Silver(Vault/3NF) vs Gold(Kimball/OBT), SCD2, point-in-time |
| 7 | 비정형 파이프라인 | IDP 6단계, 청크 메타 스키마, 계보 테이블, 재임베딩 |
| 8 | 메타데이터·시맨틱 | 카탈로그, 리니지(OpenLineage), 시맨틱 레이어, 온톨로지/그래프 |
| 9 | 저장소 선택 | 5축 매트릭스, 벡터 DB 결정, 동기화 비용 |
| 10 | 거버넌스 | 컨트랙트, 품질 게이트, 관측성, PII 태그·마스킹, 행/열 접근제어, 감사 로그 |
| 11 | 규제 매핑 | 개인정보보호법·신용정보법·전자금융감독규정, 망분리 단계별 가능 범위 |
| 12 | AI-Ready | 골든셋, 버전 5-튜플, 드리프트, 삭제 SLA |
| 13 | 스트리밍 | CDC 방식, 브로커, 처리 엔진, 멱등성, 컴팩션 |
| 14 | 비기능 | 비용 모델(스캔·호출·메모리), DR/RPO·RTO, 멀티 리전/국내 리전 |
| 15 | 로드맵·리스크 | 단계별 전환(→ 03장), 종속·성숙도 리스크와 완화 |
(b) “데이터 구조 설계” 뼈대
- 요구사항 정리(5줄): 기능(워크로드 4종), 비기능(지연·규모·가용성), 제약(규제·망·예산·인력), 성공 지표.
- 설계 원칙(5개 내외): 단일 진실(레이크하우스), 오픈 표준(Iceberg/REST/OpenLineage/ODCS), 계층 분리(진실 vs 서빙), 거버넌스 내재화(Policy-as-Code), AI 자산의 버전·계보를 핵심 관리 대상으로.
- 논리 아키텍처: 수집(배치/CDC/IDP) → 저장(메달리온 + AI 계층) → 메타데이터(카탈로그·시맨틱·그래프) → 서빙(DW/검색+벡터/그래프/온라인) → 소비(BI/ML/RAG/에이전트). 다이어그램 1개.
- 물리 구성: AWS 매핑 + 중립 대안 표. 저장소 선택 매트릭스 적용 결과.
- 거버넌스·보안: 컨트랙트–품질–관측–접근제어–감사 시간축, PII 흐름, 규제 단계별 가능 범위.
- 트레이드오프: 최소 3개(예: 중앙 vs 분산, 전용 벡터 DB vs 확장, 실시간 vs 마이크로배치, 보존 vs 삭제)와 선택 근거.
- 로드맵·리스크: 3단계(기반 → AI 계층 → 에이전트/실시간), 각 단계 산출물·리스크·완화(→ 03장).
© 자주 쓰는 핵심 문장/키워드 20
- 레이크하우스를 단일 진실 원천(Single Source of Truth)으로, 서빙 저장소는 재생성 가능한 사본으로 설계한다.
- 오픈 테이블 포맷은 Iceberg, 카탈로그 인터페이스는 Iceberg REST를 기본값으로 하여 엔진·벤더 종속을 완화한다.
- 벤더 종속의 실제 지점은 포맷이 아니라 카탈로그이므로 연합(Federation)으로 완화한다.
- 메달리온 계층은 책임과 금지 사항을 명시해야 설계로 성립한다.
- Silver는 정합성(3NF/Data Vault), Gold는 소비 최적화(Kimball/OBT)로 역할을 분리한다.
- SCD Type 2와 point-in-time 조인은 재현성과 정보 누수 방지라는 동일 원리다.
- Training-Serving Skew는 피처 정의의 단일 선언으로 구조적으로 방지한다.
- 비정형 데이터는 원본–청크–임베딩 계보 테이블로 추적·연쇄 삭제가 가능해야 한다.
- 청크 메타데이터에는 버전·유효기간·권한·임베딩 모델 버전이 포함되어야 한다.
- 재임베딩은 Blue/Green 인덱스와 별칭 전환으로 무중단 수행한다.
- 시맨틱 레이어는 지표 통일·권한 강제·환각 차단의 세 가지 가치를 제공한다.
- 온톨로지는 시스템 간 동일 개념의 의미 통합 계약서다.
- 그래프는 관계·경로 질문에, 벡터는 유사도 질문에, 둘 다면 하이브리드로.
- 저장소 선택은 워크로드·일관성·지연·비용·운영의 5축 매트릭스로 정당화한다.
- 벡터 DB는 운영 중인 DB의 확장부터 시작하고 병목을 특정할 수 있을 때 전용 DB로 전환한다.
- 데이터 컨트랙트(ODCS)로 스키마·품질·SLA를 코드화하고 CI에서 검증한다.
- PII는 탐지–태깅–태그 기반 정책–마스킹 파생본만 AI 노출의 흐름으로 통제한다.
- 망분리 로드맵에 따라 "현재 가능(가명정보)"과 "제도화 후 가능(개인신용정보)"을 구분해 설계한다.
- 모든 추론은 데이터·피처·모델·인덱스·프롬프트 5-튜플로 재현 가능해야 한다.
- 정확히 한 번은 구간 한정으로 주장하고 기본은 at-least-once + 멱등 소비로 설계한다.
(d) 자가 점검 질문 15 (짧은 답 포함)
| # | 질문 | 짧은 답 |
|---|---|---|
| 1 | 레이크가 스웜프가 되는 근본 원인과 해법은? | ACID·스키마·계보 부재 → 오픈 테이블 포맷 + 카탈로그 + 컨트랙트 |
| 2 | Iceberg를 Delta 대신 택하는 근거 3가지? | REST 카탈로그 중립성, 히든 파티셔닝·파티션 진화, 멀티 엔진 생태계(v3 행 계보) |
| 3 | Hudi를 택할 상황은? | 레코드 키 기반 초고빈도 upsert/CDC, 자동 테이블 서비스 필요 |
| 4 | 스냅샷 보존과 개인정보 삭제의 충돌 해법은? | 스냅샷 만료 정책 + 삭제 반영 SLA + 물리 파일 정리(orphan 제거) |
| 5 | Data Vault를 Silver에 두는 이유는? | 다수 소스 변경 흡수·감사 추적; 분석은 위에 마트 생성 |
| 6 | point-in-time correctness란? | 이벤트 시각 이전에 알 수 있던 피처만 조인해 누수 방지 |
| 7 | 청크 메타에 effective_from/to가 필요한 이유는? | 구·신 약관 유효 시점 기준(point-in-time) 검색, 최신성 필터 |
| 8 | 원본 삭제 요청 시 무엇을 연쇄 삭제하나? | 청크, 임베딩, 인덱스 항목, 캐시(계보 테이블 기반) |
| 9 | 시맨틱 레이어가 Text-to-SQL에 주는 효과는? | 지표 통일, 권한 강제, 존재하지 않는 조인 차단 |
| 10 | OpenSearch k-NN을 전용 벡터 DB 대신 택하는 근거는? | 하이브리드 검색·문서 수준 보안·집계를 한 시스템에서, 내부망 구축 가능 |
| 11 | 데이터 컨트랙트의 검증 시점은? | 생산자 CI(배포 전) + Bronze→Silver 적재 시 |
| 12 | 망분리 1단계에서 외부 생성형 AI에 보낼 수 있는 데이터 범위는? | 가명처리된 개인신용정보까지(샌드박스·보안대책 조건) |
| 13 | 임베딩 드리프트는 어떻게 감지하나? | 쿼리/문서 임베딩 분포 변화(중심 이동·클러스터 비율) + 골든셋 재평가 |
| 14 | 로그 기반 CDC가 쿼리 기반보다 나은 이유는? | 삭제 캡처, 원천 부하 최소, 순서 보장(LSN) |
| 15 | Lambda를 2026년 관점에서 어떻게 재해석하나? | 레이크하우스가 서빙 병합을 흡수 → 스트리밍 적재 + 스냅샷 기반 배치 재계산 |
