
레거시 키워드 검색 → 하이브리드·RAG 검색 전환
요약
상용 키워드 검색 솔루션이 사내 문서 200만 건, 일 10만 질의를 서비스 중이며 라이선스는 12개월 후 만료된다. 동의어·불용어 사전은 수작업, 상위 결과 클릭률 35%로 만족도가 낮다. 오픈 표준 기반 하이브리드 검색 + RAG를 무중단으로 도입하고 품질 개선을 수치로 입증하는 전환 단계, 인덱스 마이그레이션, 기준선·평가, 트래픽 전환·롤백, 임베딩 모델 교체 대비 전략을 설계한다.
1. 요구사항·제약·가정
검색 전환은 DW 전환과 달리 정답이 결정적이지 않아 행 수 비교 같은 Reconciliation이 불가능하다. 따라서 골든셋 + 평가 지표 + 레거시 기준선이 정합성 증명의 역할을 대신하며, 이것이 설계 전체를 지배하는 제약이다.
| 구분 | 내용 | 설계 함의 |
|---|---|---|
| 규모 | 문서 200만 건, 일 10만 질의(피크 약 10 QPS 가정), 평균 10청크/문서(가정) → 약 2,000만 청크 | 벡터 메모리·재임베딩 비용이 설계 변수 |
| 기한 | 라이선스 만료 12개월 | M10 100% 전환, 2개월 버퍼. 레거시 인덱스 역추출 금지 → 원천 재수집 기간 확보 |
| 품질 | 상위 결과 클릭률 35%, 사전 수작업 | 기준선 nDCG@10 측정 후 목표 +20%(가정), 클릭률 35% → 50%(가정) |
| 무중단 | 전환 중 서비스 중단·품질 급락 금지 | 섀도 → 점진 트래픽 → alias 스왑, 라우터 플래그 롤백 |
| 한국어 | 사내 용어·약어·상품명 | nori + 사용자 사전 + 검색 시 동의어 |
| 가정 | 원천 문서 저장소에 재접근 가능, 임베딩·리랭커는 사내 호스팅 또는 프라이빗 엔드포인트, 문서별 ACL 존재 | 가정을 답안에 명시 |
2. 설계 원칙
- 기준선 없이는 전환하지 않는다: 레거시의 nDCG@10·클릭률·무결과율을 먼저 기록해야 "좋아졌다"를 증명하고 규제·감사에 대응할 수 있다.
- 원천에서 재색인한다: 레거시 인덱스를 역추출하면 구 분석기·매핑의 한계를 승계한다.
- 모든 전환 단위는 원자적으로 스왑·복귀 가능해야 한다: 인덱스는 alias, 트래픽은 라우터 플래그.
- 검색을 먼저 안정화하고 생성(RAG)은 별도 토글로 얹는다: 검색 품질이 답변 품질의 상한이다.
- 모델 교체를 설계 시점에 전제한다: 청크·임베딩 버전 테이블과 인덱스명의 모델 버전이 재임베딩을 가능하게 한다.
3. 기준선 확보 — 암묵 라벨과 골든셋의 역할 분리
기준선은 두 종류의 라벨로 만든다. 역할이 다르므로 둘 다 필요하다.
| 라벨 | 구축 | 규모 | 강점 | 한계 | 용도 |
|---|---|---|---|---|---|
| 암묵 라벨(클릭) | 레거시 쿼리 로그에서 상위 질의 1만 개 추출, 클릭·체류·재질의를 관련도 신호로 변환 | 1만 질의 | 실제 분포 반영, 저비용, 롱테일 질의군까지 커버 | 위치 편향(상위 결과가 더 클릭됨), 레거시가 못 찾은 문서는 라벨이 없음(신 시스템의 개선을 과소평가) | 질의군별 회귀 탐지, 온라인 지표 기준선, 인터리빙 비교 |
| 골든셋(명시 라벨) | 전문가가 유형별(사실·절차·비교·다중홉·답 없음) 층화 샘플 500개에 정답 요지 + 근거 문서 ID 부여, 2인 교차 검증 | 500 | 레거시 편향 없음, nDCG·Recall 계산 가능, “답 없음” 10~20%로 거부 정책 평가 | 구축 비용, 분기 갱신 필요 | 오프라인 nDCG@10·Recall@50, CI 회귀 게이트, 임베딩 모델 비교 |
측정 지표는 nDCG@10(등급 관련도를 log2 할인해 이상적 순위(ideal ranking) 대비 정규화), Recall@50(1단계 후보 재현율), MRR, 무결과율, 상위 결과 클릭률(35%), p95 지연이다. 기준선 수치는 승인(sign-off)을 받아 기록하며, 이후 모든 단계의 종료 기준은 이 수치 대비 상대값으로 정의한다. 골든셋은 문서 개정 시 근거 청크를 재매핑하고 코드처럼 버전 관리한다.
4. 전환 단계
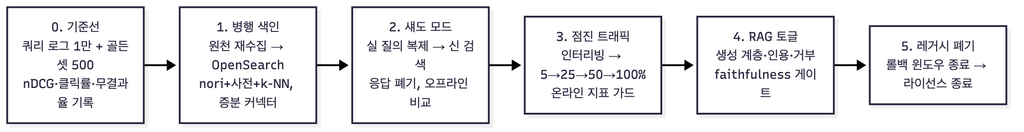
(손그림: 박스 6개를 가로로, 각 박스 아래에 종료 기준 한 줄.)
| 단계 | 기간(12개월) | 핵심 활동 | 종료 기준 |
|---|---|---|---|
| 0. 기준선 | M0~1 | 로그 추출, 골든셋 500 구축, 레거시 지표 측정 | 골든셋 승인, 기준선 승인 |
| 1. 병행 색인 | M1~3 | 원천 재수집 파이프라인, nori·사용자 사전·동의어 이관, 청킹·임베딩, k-NN 인덱스, ACL 필드, 증분 커넥터 | 색인 커버리지 100%, 색인 지연 SLO(신규 문서 15분 이내) |
| 2. 섀도 | M3~5 | 라우터가 질의를 복제해 신 검색에 전송, 결과 로깅, 오프라인 비교, 사전 누락·질의군 악화 탐지 | 골든셋 nDCG@10 ≥ 기준선 +10%, p95 < 300ms, 오류율 < 0.1% |
| 3. 점진 트래픽 | M5~8 | 인터리빙으로 민감 비교 → 사용자 단위 A/B 5% → 25% → 50% → 100%, 각 단계 최소 1주 | 단계별 클릭률 저하 없음(기준선 −2pp 이내), 무결과율·지연·오류율 가드 통과 |
| 4. RAG 도입 | M7~10 | 검색 위에 생성 계층, 인용 강제·거부 정책, 가드레일, 별도 토글로 부서 단위 확대 | faithfulness ≥ 0.9(골든셋), 거부 정확도, 휴먼 평가 통과 |
| 5. 폐기 | M10~12 | 100% 전환 후 롤백 윈도우 1개월, 레거시 인덱스 스냅샷 보관 | 롤백 윈도우 종료, 라이선스 종료 |
RAG를 검색과 분리해 뒤에 두는 이유는, 생성 품질의 상한이 검색 품질이고, 검색이 흔들리는 동안 RAG를 얹으면 👎의 원인이 검색인지 생성인지 분리할 수 없기 때문이다.
5. 인덱스 마이그레이션
재색인은 원천에서 한다. 분석기(nori)·매핑·청킹이 모두 바뀌므로 상용 솔루션 인덱스를 역추출하는 방식은 구 토크나이저의 한계를 승계하고, 이기종 간 스냅샷/복원도 불가능하다. 원천 문서 저장소에서 새 파이프라인(파싱 → 구조 기반 청킹 300~500토큰 → 메타데이터 → 임베딩 → bulk 색인)으로 200만 건을 재색인하며, 초기 색인 중에도 증분 커넥터를 병행 가동해 전환 기간의 신규·수정 문서가 유실되지 않게 한다. 쓰기 alias와 읽기 alias를 분리하면 전환 중 신규 문서가 양쪽에 기록된다.
사전 이관과 검증: 수작업 동의어·불용어·사용자 사전을 내보내 nori 사용자 사전과 검색 시 동의어 필터로 이관한다. 동의어는 색인 시가 아니라 검색 시 분석기에 두어야 사전 갱신에 리인덱스가 필요 없다. 이관 검증은 (1) 사전 항목별로 레거시와 신 시스템의 토큰화 결과를 자동 비교, (2) 암묵 라벨 1만 질의를 질의군(상품명·약어·일반어)으로 나눠 군별 nDCG 변화를 비교해 특정 군의 급락(사전 누락 신호)을 탐지, (3) 골든셋 500으로 전체 수준 확인의 3단계로 한다. 부스팅 규칙(최신 문서·공지 가중)은 function_score 쿼리로 옮기고 같은 방법으로 검증한다.
인덱스 구조와 용량: 단일 OpenSearch 인덱스에 BM25 필드(nori) + k-NN 벡터 필드(HNSW, M=16) + 메타 필드(출처·버전·부서·유효기간·allowed_principals)를 둔다. 벡터 메모리는 1.1×(4d+8M) 근사식으로 1024차원 fp32가 약 4.6KB/벡터, int8이 약 1.27KB/벡터이므로 2,000만 청크는 fp32 약 92GB, int8 약 25GB(레플리카 1개 포함 시 각 2배)다. k-NN 서킷 브레이커(노드 RAM 50%)를 고려해 int8을 채택하고 재현율 손실은 골든셋으로 확인한다. 인덱스명은 docs-v1-{embedding-model-id} 형식으로 모델 버전을 포함하고, 애플리케이션은 search-docs alias만 참조한다.
alias blue/green: docs-v1(blue) 서비스 중 docs-v2(green)를 색인·검증한 뒤 alias를 actions: [remove, add]로 원자적으로 교체하며, 문제 시 alias를 되돌리면 롤백이 끝난다. 비용은 이중 스토리지이고, 이득은 다운타임 0과 즉시 복귀다.
6. 품질 개선 수단과 우선순위
| 순위 | 수단 | 메커니즘 | 기대 효과 | 비용·주의 |
|---|---|---|---|---|
| 1 | 하이브리드 + RRF(k=60) | BM25(코드·고유명사·정확 매칭)와 k-NN(의미·동의 표현)의 실패 영역이 다르므로 순위 기반 융합 score(d)=Σ1/(k+rank_i) | 사전 없이도 “실비 ↔ 실손의료보험” 류 표현 변이(동의어·약어) 흡수 | RRF는 튜닝 없이 강건, 가중합은 골든셋 확보 후 |
| 2 | cross-encoder 재순위 | 후보 50→상위 10을 질의-문서 쌍으로 정밀 채점 | nDCG@5를 가장 크게 올리는 단일 개선 수단인 경우가 많음 | 지연 +200~400ms, 후보 수에 선형 → p95 예산 내 N 결정 |
| 3 | nori + 사용자 사전 + 검색 시 동의어 | 복합명사 분해(decompound_mode: mixed), 사내 용어 즉시 반영 |
가성비 최고 | 사전 운영 프로세스 필요 |
| 4 | 구조 기반 청킹·small-to-big | 조·항·제목 단위 청크로 정밀도, 부모 문맥으로 생성 | 규정류 문서 품질 | 파싱 품질(HWP·표) 의존 |
| 5 | 질의 재작성·필터 추출 | 오타·약어 확장, 부서·문서유형 필터 자동 추출 | 무결과율 감소 | 소형 모델로 지연 억제 |
| 6 | 클릭 피드백 → LTR | 온라인 신호로 학습 | 장기 개선 | 위치 편향 보정 필요, 후순위 |
7. 트래픽 전환·롤백
라우터가 전환의 제어점이다. 질의는 검색 게이트웨이(라우터)를 거쳐 레거시 또는 신 검색으로 가며, 라우터는 (1) 섀도 복제, (2) 인터리빙(두 랭커 결과를 섞어 보여주고 클릭 비교 — A/B보다 적은 트래픽으로 민감), (3) 사용자 단위 A/B 비율, (4) 즉시 복귀 플래그를 제공한다. 사용자 단위 분할은 같은 사용자가 단계마다 다른 결과를 보는 혼란을 막는다.
지표 가드(자동 롤백 임계, 가정): 단계별로 다음 중 하나라도 발생하면 플래그를 레거시로 되돌린다.
| 지표 | 기준선 | 가드 임계 |
|---|---|---|
| 상위 결과 클릭률 | 35% | 신 시스템이 기준선 −3pp 이하로 1시간 지속 |
| p95 지연 | 레거시 측정값 | 300ms 초과 또는 기준선 +50% |
| 오류율 | — | 1% 초과 5분 지속 |
| 무결과율 | 레거시 측정값 | 기준선 +2pp |
| 권한 위반 | 0 | 1건이라도 발생 시 즉시 |
롤백은 라우터 플래그 전환(초 단위)이며, 인덱스 수준 문제는 alias 복귀로 처리한다. 롤백 후에는 👎·클릭 로그 샘플 100건을 분류해 원인을 사전·청킹·융합 가중치·지연 중 하나로 확정한 뒤 재진입한다. 레거시는 100% 전환 후에도 롤백 윈도우 1개월 동안 색인을 유지한다.
8. 임베딩 모델 교체 대비
임베딩 모델을 바꾸면 기존 벡터와 호환되지 않으므로(차원·공간 상이) 전량 재임베딩이 원칙이다. 설계 시점에 이를 전제한다.
- 계보 테이블:
document / chunk / embedding_version을 Iceberg 테이블로 관리해 청크별 모델 ID·버전·임베딩 시각을 기록한다(→ 01장). 벡터 인덱스는 이 테이블의 파생물이며 언제든 재생성 가능해야 한다. - 비용 산정식: 비용 = 문서 수 × 평균 청크 수 × 청크 평균 토큰 × 단가. 200만 × 10청크 × 400토큰 = 80억 토큰(가정). 관리형 API라면 토큰 단가(가정, 가격표 확인)를 곱하고, 자체 호스팅이면 GPU 시간으로 환산한다 — 예: GPU 1대 5,000토큰/s(가정)면 약 444시간(18.5일)이므로 병렬 GPU 또는 배치 추론이 필요하다. 시간 제약이 비용보다 먼저 걸리는 경우가 많다.
- 절차: 후보 모델을 골든셋으로 오프라인 비교(nDCG@10, 한국어 리더보드는 참고만) → 신 인덱스
docs-v2-{new-model}병행 구축, 증분 문서는 양쪽 인덱스에 이중 쓰기 → 섀도 → alias 스왑 → 구 인덱스 보존 기간 후 삭제. 롤백은 alias 복귀. - 우선순위 재임베딩: 접근 빈도 상위 문서부터 재임베딩하고 롱테일은 지연 처리하면 전환 기간을 단축할 수 있으나, 혼합 기간에는 모델별 인덱스를 분리해 벡터 공간이 섞이지 않게 한다.
- 교체하지 않을 조건: 평가 이득이 재임베딩 비용·리스크를 넘지 못할 때, 외부 API 모델이 비학습·데이터 레지던시 요건을 못 맞출 때.
9. 핵심 설계 결정
| 결정 | 선택 | 근거 | 대안 | 트레이드오프 |
|---|---|---|---|---|
| 엔진 | OpenSearch 단일 엔진(BM25 + k-NN + DLS) | 하이브리드·권한 필터·운영을 한 곳에서, 오픈 표준 | 벡터 전용 DB + 키워드 엔진 | 두 시스템 동기화·권한 이중 관리 vs 전용 DB 성능 |
| 인덱스 이관 | 원천 재색인 | 분석기·청킹 변경, 구 매핑 한계 미승계 | 원격 재색인·역추출 | 시간·컴퓨트 vs 클린 재구축 |
| 융합 | RRF 기본, 가중합은 골든셋 확보 후 | 튜닝 없이 강건 | 정규화 가중합 | 질의별 가중 불가 |
| 전환 제어 | 라우터 플래그 + 인터리빙 + A/B | 초 단위 롤백, 적은 트래픽으로 민감 비교 | DNS/LB 전환 | 라우터 운영 비용 |
| 양자화 | int8 + rescoring | 메모리 1/4, 서킷 브레이커 여유 | fp32 | 재현율 소폭 저하 → 골든셋 확인 |
| RAG 도입 시점 | 검색 안정화 후 별도 토글 | 원인 분리, 상한은 검색 품질 | 동시 도입 | 가치 실현 지연 |
10. 리스크
| 리스크 | 징후 | 완화 |
|---|---|---|
| 사전 이관 누락 | 특정 질의군(상품명·약어) nDCG 급락 | 토큰화 자동 비교, 질의군별 기준선 비교, 섀도 기간 사전 보강 |
| 지연 증가 | p95 300ms 초과 | 재순위 후보 수 축소, ef_search 동적 조정, 캐시 적중 질의는 재순위 생략 |
| 권한 유출 | 권한 밖 문서 노출 | ACL pre-filter, 기본 거부, 권한 위반 1건 시 즉시 롤백 |
| 파싱 품질(HWP·표) | 깨진 청크, 저품질 상위 결과 | 파싱 실패율 모니터링, 상용 파서 병행 |
| 사용자 혼란 | 인터페이스 변화 불만 | UI 점진 변경, 사용자 단위 A/B, 변경 공지 |
| 암묵 라벨 편향 | 신 시스템 개선 과소평가 | 골든셋 병행, 인터리빙으로 보정 |
| 라이선스 만료 전 미완료 | 단계 지연 | M10 100% 목표 + 2개월 버퍼, 단기 연장 옵션 협상 |
11. 결론
본 설계는 기준선(암묵 라벨 1만 + 골든셋 500)을 먼저 확보해 품질 개선을 수치로 증명하고, 원천 재색인·alias blue/green·라우터 플래그로 무중단과 즉시 롤백을 보장하며, 섀도 → 인터리빙 → 5/25/50/100% 점진 전환으로 리스크를 분산한다. 품질은 하이브리드+RRF, 재순위, 한국어 사전의 순으로 올리고, RAG는 검색 안정화 후 별도 토글로 얹는다. 임베딩 모델 교체는 전량 재임베딩을 전제로 계보 테이블·모델 버전 인덱스명·이중 쓰기로 대비한다. 핵심 트레이드오프는 재순위의 정밀도 vs 지연, 양자화의 메모리 vs 재현율, 원천 재색인의 클린 재구축 vs 시간이다.
