
온프레미스 DW → 클라우드 레이크하우스 전환 설계
요약
Oracle Exadata DW 50TB(연 20% 증가), ETL 잡 1,200개(상용 700 + PL/SQL 500), BI 리포트 300개(규제 보고 40개 포함), 야간 배치 6시간 윈도우가 7시간으로 초과, 라이선스 갱신 18개월 후. 18개월 내 클라우드 레이크하우스 전환, 규제 보고 무중단, 비용 30% 절감, AI 워크로드 수용을 달성하는 전환 전략·As-Is 평가·To-Be·이관·검증·컷오버·롤백·리스크·로드맵·KPI를 설계한다. 제약: 금융권 규제, 데이터 팀 15명 + 외부 인력.
1. 추진 배경·목표·KPI·제약·가정
전환을 추진하는 이유는 "선택"이 아니라 "기한"이다. 라이선스 갱신 시점(M18)이 레거시의 종료 시점(EOL)이므로, 설계의 모든 일정은 M18에서 역산한다. 추진 배경을 측정 가능한 페인 포인트로 환산하면 다음과 같다.
| 추진 요인 | 현재의 페인 포인트(정량) | KPI(18개월) | 측정 방법 |
|---|---|---|---|
| 라이선스 만료 | 갱신 시 유지보수 포함 고정비 지속, 하드웨어 교체 주기 도래 | 5년 TCO −30%(이중 운영 기간 비용 포함 산정) | FinOps 태깅 청구 데이터 vs 온프레미스 감가상각+라이선스+인건비 |
| 배치 윈도우 초과 | 6시간 윈도우에 7시간 소요 → 아침 리포트 지연, 월말 SLA 위반 | 배치 완료 시각 06:00 → 04:00 이내(잔여 배치 4시간 이하) | 오케스트레이터 메타데이터 |
| 규제 보고 | 40개 리포트가 DW 스키마에 하드코딩, 수치 불일치 시 규제 리스크 | 규제 보고 수치 불일치 0건(Reconciliation 증적) | 검증 프레임워크 |
| AI 수용 불가 | 문서·로그를 모델·RAG에 쓸 수 없음, 피처 재현 불가 | AI 유스케이스 2개 이상 운영 진입(검색·스코어링) | 포털·레지스트리 |
| 민첩성 | 신규 파이프라인 리드타임 수주 | 중앙값 2주 → 2일 | 티켓 생성~배포 |
| 신뢰성 | 월말 SLA 위반 | 월 SLA 위반 0건, MTTR 30분 이내 | 알림·장애 기록 |
용량은 18개월 뒤 약 66TB(50TB × 1.2^1.5)이고, 상위 20% 테이블이 80% 용량·쿼리를 차지하는 파레토 분포를 가정한다. Out of scope는 코어 원장(Retain, CDC 복제만)과 종이 문서 OCR이며, 범위 확산이 전환 실패의 1순위 원인이므로 "하지 않을 것"을 먼저 고정한다. 가정: (1) 금융권 클라우드 이용 절차를 거쳐 하이브리드 이용이 허용된다, (2) Oracle 보조 로깅(supplemental logging)과 스탠바이에서의 로그 추출에 DBA가 협조한다, (3) 온프레미스↔클라우드 전용선 1Gbps(가정)가 있다.
2. 전환 전략 선택
전체 실행 방식은 Phased + Strangler Fig + Wave별 Parallel Run이다. Big Bang은 배제한다. 1,200개 잡의 의존성이 하나의 거대 그래프를 이루고, 규제 보고 40개가 다운스트림에 걸려 있어 일괄 컷오버 실패 시 롤백이 사실상 불가능하기 때문이다. 다만 원자적 전환이 가능한 단위(뷰 정의 교체, 검색 인덱스 alias 스왑)에는 Big Bang식 스왑을 쓴다. Strangler Fig는 "신규 파이프라인 요청은 신 플랫폼에만 받는다"는 규칙으로 구현되며, 이것이 레거시 잡 수가 전환 중에 더 늘어나는 것을 막는다.
워크로드군별 7R 매핑은 다음과 같다. Refactor 비중이 높을수록 병행 운영 기간과 검증 비용이 커지므로, Retire를 먼저 적용해 Refactor 대상 자체를 줄인다.
| 워크로드군 | 규모(가정 포함) | 7R | 실행 방식 | 근거 |
|---|---|---|---|---|
| 1년 미접근 테이블, 미사용 리포트 | 테이블 30%, 리포트 300 중 약 100(사용 로그 기준, 가정) | Retire | 소유자 확인 → 보존 의무분만 아카이브 | 이관·검증 범위 즉시 30% 축소. 보존 의무 데이터는 불변 저장 후 폐기 |
| 코어 원장·계약 시스템 | — | Retain | 로그 기반 CDC로 복제만 | 코어 변경 리스크·규제. 분석 플랫폼은 사본으로 동작 |
| 단순 적재·표준 SQL 잡 | 상용 ETL 700 중 약 60%(가정) | Replatform | 메타데이터 내보내기 → dbt/Spark 코드 자동 생성 | 변환 의미가 단순해 자동 변환율 높음. Wave 1의 퀵윈 후보 |
| 복잡 PL/SQL(커서·동적 SQL·다단 머지) | PL/SQL 500 중 약 40%(가정) | Refactor | 리니지 기준 재설계(dbt 모델·Spark), 동등성 테스트 | 1:1 변환은 성능 특성·NULL 의미를 승계하므로 재설계가 유지보수에 유리. 마지막 Wave |
| 규제 보고 40개 | 리포트 40 + 상류 잡 | Retain → 마지막 Wave Refactor | Parallel Run 8주, 이중 생성 비교 | 오류 시 규제 리스크가 가장 크므로 도구·경험·검증 프레임워크 확보 후 착수 |
| BI 리포트(활성) | 약 200 | Replatform(뷰 추상화) | 시맨틱 레이어·뷰 경유로 재연결 | 리포트 SQL 수정 최소화 |
| 배치 스코어링 모델 | (있을 경우) | Replatform | 피처 정의 추출 → 레지스트리 등록 → parallel scoring | 점수 재현 허용 오차 사전 합의 |
복잡도 × 가치 매트릭스로 Wave 순서를 정한다. 저복잡·고가치(영업 실적·고객 마트)를 Pilot/Wave 1로, 고복잡·고가치(계리·규제 보고)를 마지막 Wave로 둔다. 규제 민감도 축을 추가하면 개인신용정보 포함 워크로드는 중요도 평가를 먼저 통과해야 하므로, 규제 절차를 Discovery와 병렬로 "Wave 0"으로 착수해 전체 일정이 늘어나지 않게 한다. 하이브리드는 선택이 아니라 Retain 원장이라는 제약에서 도출되며, 멀티클라우드는 운영 역량(15명)과 데이터 중력을 이유로 채택하지 않는다.
3. As-Is 평가 — Wave 순서·R 선택·규제 절차의 입력
As-Is는 "조사했다"가 아니라 이후 모든 선택의 근거가 되는 산출물이어야 한다.
- 데이터 인벤토리: 테이블별 행 수·바이트·월 증가율·마지막 접근일·소유자·보존 의무를 수집한다. 접근 로그를 최소 13개월 확보해 분기·연 1회 접근 자산을 Retire로 오탐하지 않는다. 기대 결과(예): 1년 미접근 테이블 30% → Retire 후보, 상위 20% 테이블이 용량·쿼리 80% 점유 → Wave 1차 근거.
- 의존성 그래프: 소스 테이블 → ETL 잡 → 중간 테이블 → 리포트·외부 전송을 노드로, 읽기/쓰기를 엣지로 그래프 DB(Neptune/Neo4j)에 적재한다. ETL 툴 메타데이터 내보내기, PL/SQL 파싱, 쿼리 로그에서 엣지를 추출한다. 그래프를 약연결 성분으로 분할하면 Wave 단위가 나오고, 모든 것이 하나의 컴포넌트면 Strangler용 파사드 뷰로 인위적 절단면을 만든다. “이 테이블을 옮기면 영향받는 리포트” 질의를 자동화한다.
- 배치 크리티컬 패스 분석: 잡 스케줄러 로그로 7시간 윈도우의 임계 경로를 식별한다. 보통 소수의 대형 전체 재적재(full refresh) 잡이 경로의 절반 이상을 차지하며(예: 상위 10개 잡이 3.5시간), 이들은 CDC·증분 MERGE로 바꾸면 분 단위로 줄어든다. 임계 경로 밖의 잡은 병렬화만으로 충분하다. 이 분석이 "배치 윈도우 해결"의 설계 근거이며, 컴퓨트를 늘려도 임계 경로의 직렬 의존이 그대로면 윈도우는 줄지 않는다는 점이 실패 모드다.
- 워크로드 프로파일링: AWR/쿼리 로그로 스캔 vs 포인트 조회 비율, 조인 깊이, 피크 동시성, 일일 변경 행 비율(redo 양)을 측정한다. 변경률은 CDC 용량과 Iceberg MOR/COW 선택의 입력이다.
- 민감도 분류: 컬럼 단위로 공개/내부/기밀/개인정보/개인신용정보/고유식별정보를 태깅한다. 주민등록번호·계좌·카드 패턴은 커스텀 규칙이 필요하다. 이 맵이 없으면 중요도 평가도, 비운영 환경 마스킹도 불가능하다.
- 품질 기준선: 핵심 테이블의 NULL률·중복 키·참조 무결성 위반·분포 통계를 전환 전에 측정하고 현업 승인(sign-off)을 받는다. 전환 후 품질 논쟁에서 "원래 그랬다"를 증명할 유일한 수단이다.
- 코드 복잡도: PL/SQL 라인 수·커서·동적 SQL·패키지 간 호출을 점수화해 자동 변환 가능군과 재설계군을 나눈다.
4. To-Be 아키텍처
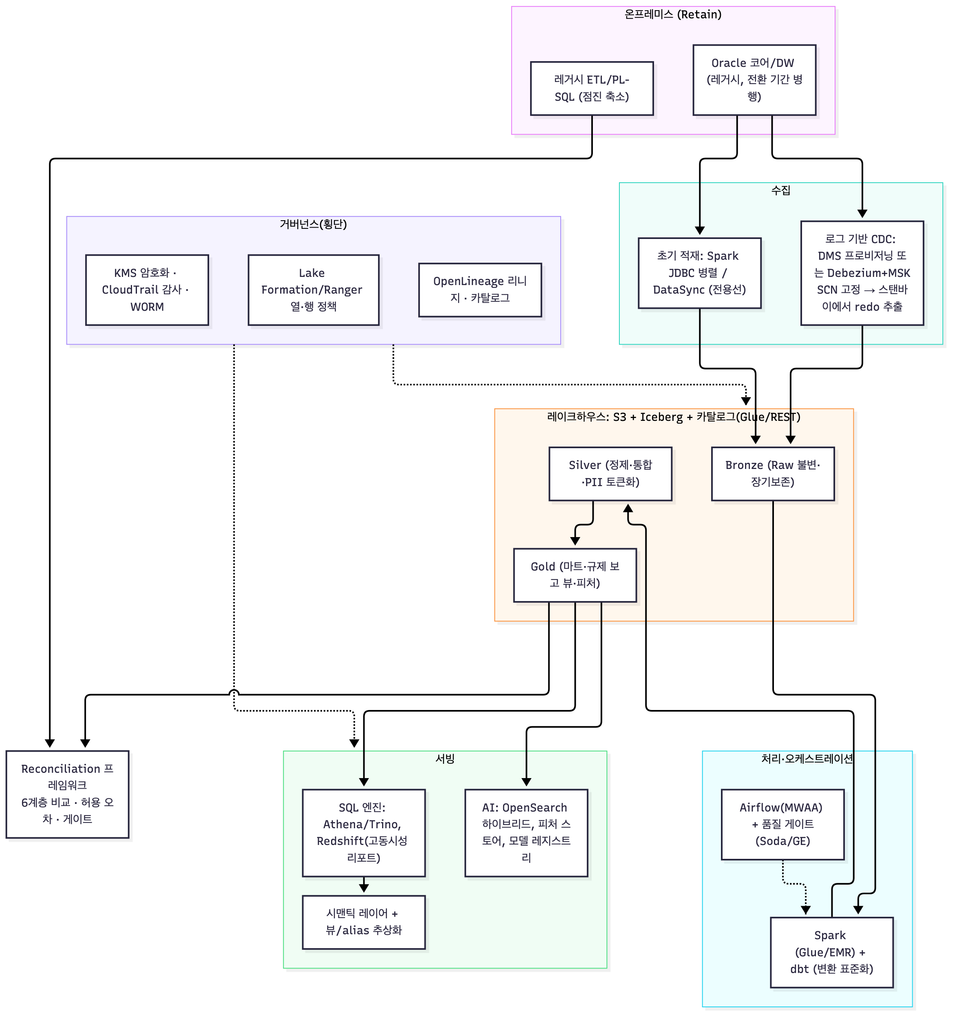
(손그림: 왼쪽 온프레미스 박스 → 가운데 CDC/초기적재 → Bronze·Silver·Gold 3단 → 오른쪽 SQL·시맨틱·AI 서빙, 아래에 거버넌스 가로 막대, 레거시와 Gold 양쪽에서 Reconciliation 박스로 화살표.)
계층별 선택과 핵심 결정은 다음 표로 정리한다.
| 결정 | 선택 | 근거 | 대안 | 트레이드오프 |
|---|---|---|---|---|
| 테이블 포맷·카탈로그 | Apache Iceberg + Glue 카탈로그(Iceberg REST 호환) | 엔진 중립, 스키마·파티션 진화, 스냅샷 타임트래블로 백필·재현, 이식 가능한 단일 클라우드 전략의 핵심 | Delta Lake(Databricks 결합), Hudi(업서트 특화) | 컴팩션·스냅샷 만료 운영 필요. 파티션당 파일 128MB~1GB 목표, 과도한 파티셔닝이 가장 흔한 실패 |
| CDC 경로 | DMS 프로비저닝 인스턴스 → S3 Parquet → Spark MERGE INTO Iceberg(대안 Debezium+MSK+Spark) | 사용자 지정 CDC 시작점·재처리가 중요한 금융 워크로드엔 Serverless보다 프로비저닝이 안전. DMS의 Iceberg 직접 타깃 범위는 확인 필요이므로 S3 경유 패턴 채택 | 쿼리 기반 CDC(updated_at 폴링) | 로그 기반은 보조 로깅·DBA 협조 전제. 쿼리 기반은 삭제 미포착·소스 부하 |
| 변환 계층 | dbt(SQL) + Spark(비SQL·대용량) | 테스트·문서·리니지 표준화, 15명 팀이 유지 가능한 코드 기반 변환 | 상용 ETL 툴 클라우드판(Replatform) | 재작성 공수 vs 리니지 불투명·라이선스 지속 |
| 배치 윈도우 해결 | 임계 경로 상위 잡을 CDC+증분 MERGE로 마이크로배치(15분~1시간)화, 나머지는 탄력 컴퓨트로 병렬화 | 윈도우는 직렬 의존이 결정하므로 임계 경로의 전체 재적재를 증분화해야 줄어든다 | 컴퓨트 증설만 | 멱등 MERGE 재작성 공수 vs 윈도우 50% 이상 단축 |
| SQL 엔진 | Athena/Trino(탐색·대용량 스캔) + Redshift(고동시성 리포트, 선택) | 워크로드별 엔진 분리. 서버리스는 상시 고부하에서 비용 역전 | 단일 엔진 | 엔진 2개 운영 vs 비용·동시성 |
| 리포트 호환 | 시맨틱 레이어 + 뷰/alias 추상화 | 소비자는 뷰만 참조 → 컷오버 시 뷰 정의만 교체, 롤백도 뷰 복귀 | 리포트 SQL 개별 수정 | 뷰 오버헤드 vs 300개 리포트 수정 공수 |
| 오케스트레이션 | Airflow(MWAA) + 품질 게이트 내장 | 표준 배치 DAG, 인력 확보 용이, 커넥터 풍부 | Dagster(자산 중심), Step Functions | 동적 플로우 약함 vs 생태계 |
| 접근제어 | Lake Formation 열·행 정책 + 정책 코드화(Terraform) | 온프레미스 Ranger와 이중 관리를 피하려면 정책을 단일 소스로 두고 양쪽 배포 | 뷰 단 마스킹 | 초기 정책 설계 공수 |
핵심 결정 세 가지를 메커니즘 수준에서 상술한다.
(1) Iceberg 선택 이유는 전환 중의 재현성이다. Iceberg는 스냅샷→매니페스트 리스트→매니페스트→데이터 파일의 메타데이터 트리를 가지므로, Parallel Run 중 특정 시점의 테이블 상태를 스냅샷 ID로 고정해 레거시와 비교할 수 있고, 변환 버그 수정 후 백필은 파티션 overwrite로 원자적으로 수행된다. 히든 파티셔닝(days(ts))은 리포트 SQL이 파티션 컬럼을 몰라도 프루닝하므로 레거시 SQL 호환성을 높인다. 실패 모드는 CDC가 양산하는 소형 파일과 삭제 파일이며, rewrite_data_files·rewrite_position_delete_files 컴팩션과 스냅샷 만료를 자동화하지 않으면 쿼리 지연이 수 배로 증가한다.
(2) CDC 시작점 고정이 초기 적재보다 먼저다. 초기 적재 50TB는 전용선 1Gbps(이론상 약 10TB/일, 실효 50%면 약 5TB/일)로 약 10일이 걸린다(가정). 이 10일 동안의 변경이 유실되지 않으려면 적재 시작 전 Oracle SCN을 기록하고, 적재 완료 후 그 SCN 이후의 redo를 재생해 일관 시점(consistent point)에 도달해야 한다. 순서를 거꾸로 하면 공백(gap)이 생기고, 공백은 Reconciliation에서 "원인 불명 불일치"로 나타난다. 소스 부하를 피하기 위해 추출은 스탠바이에서 수행하고, CDC 지연 SLO(예: 5분)와 알림을 둔다.
(3) 듀얼 라이트는 쓰지 않는다. 애플리케이션이 Oracle과 레이크하우스에 동시에 쓰는 방식은 부분 실패 시 불일치를 만들고 트랜잭션 보장이 없다. 신 플랫폼은 CDC로만 채우고, 양쪽 파이프라인이 같은 입력을 처리해 출력을 비교하는 Parallel Run으로 정합성을 증명한다.
5. 데이터·코드 이관
데이터 이관 순서는 "SCN 고정 → 초기 적재(Bronze) → CDC 증분 재생 → 수렴 확인 → Parallel Run"이다. 초기 적재는 테이블 단위 Spark JDBC 병렬 읽기(스탠바이 대상)를 기본으로 하고, 회선 대역폭이 부족하면 오프라인 디바이스(Snowball)를 쓰되 반출 승인·암호화·봉인 증적이 리드타임을 수주 늘린다는 점을 계획에 반영한다. Bronze는 불변·장기 보존이며, Silver 이후는 언제든 재생성 가능해야 리플레이가 성립한다.
스키마 변환 함정은 집계값 차이의 주범이므로 테이블·컬럼별 매핑 표를 명시한다.
| 이슈 | 함정 | 대응 |
|---|---|---|
| NUMBER 정밀도 | Oracle NUMBER(정밀도 무제한) → DOUBLE 변환 시 반올림, DECIMAL(38,x) 절삭 | 금액은 DECIMAL 고정(예: DECIMAL(18,2)), 정밀도 손실 테스트를 동등성 테스트에 포함 |
| 타임존 | 서버 로컬(KST) 암묵 저장 → UTC 엔진에서 9시간 시프트, 월말 23:00 이후 거래가 익월 귀속 | TIMESTAMP WITH TIME ZONE 또는 UTC + 명시 변환, 기준 시각을 데이터 컨트랙트에 명문화 |
| 문자셋 | EUC-KR/MS949 → UTF-8 변환 시 한자·특수문자 깨짐, 바이트 기준 VARCHAR2 오버플로 | 비ASCII 샘플 사전 검증, 길이 단위(byte vs char) 재산정 |
| NULL/빈 문자열 | Oracle은 ‘’ = NULL, Spark/Trino는 구분 → 조인·필터 결과 상이 | 정규화 규칙 명시(빈 문자열→NULL), 비교 로직 재검토 |
| 제약·시퀀스 | 레이크하우스는 PK/FK 미강제 | 품질 게이트로 유일성·참조 무결성 검증 |
코드 변환은 자동 변환 + LLM 보조 + 동등성 테스트의 3중 구조다. DMS Schema Conversion(구 SCT) 류로 DDL·PL/SQL을 변환하고 SQLGlot으로 dialect를 트랜스파일하되, 자동 변환율은 객체 복잡도에 따라 크게 달라지므로 "변환됐다"를 "맞다"로 간주하지 않는다. LLM 보조 변환은 보일러플레이트·주석·테스트 생성을 가속하지만 의미 보존을 보장하지 않고 존재하지 않는 함수를 환각하므로, 반드시 데이터 기반 동등성 테스트와 사람 리뷰를 결합한다. 동등성 테스트는 동일 입력 스냅샷(Iceberg 스냅샷 ID 고정)에 레거시 잡과 신 잡을 실행해 출력 테이블을 6계층으로 비교하는 것이며, 변환 불가로 판정된 약 20%(가정)는 리니지 기준으로 재설계한다. 레거시의 “INSERT 누적” 잡은 전환 시 MERGE INTO 기반 멱등 잡으로 재작성해야 재처리가 안전하다.
Parallel Run은 Wave별로 레거시와 신 파이프라인을 동시에 돌리고 결과를 자동 비교한다. 일반 마트 4주, 규제 보고 8주를 기본으로 하며, 비교 자동화 없이 수작업 비교하는 Parallel Run은 비용만 2배이고 확신은 주지 못한다.
6. 정합성 검증(Reconciliation) 6계층과 합격 기준
검증은 비용과 신뢰가 함께 오르는 6계층으로 구성하고, 전 계층을 파티션 단위로 자동화한다.
| 계층 | 내용 | 탐지 대상 | 비용 |
|---|---|---|---|
| 1. 행 수 | 파티션별 COUNT, 키 집합 차집합 | 누락·중복 적재 | 최저 |
| 2. 열 집계 | SUM/COUNT DISTINCT/MIN/MAX/NULL 수 | 수치 컬럼 오류, 정밀도 | 낮음 |
| 3. 행 해시 합 | 정규화 문자열의 MD5 앞 8자리를 정수로 합산 | 임의 컬럼 변조, 순서 무관 | 중간 |
| 4. 샘플 행 비교 | 키 기준 N행 전체 컬럼 비교 | 타입·문자셋·타임존 오류 | 중간 |
| 5. 통계 분포 | 히스토그램·분위수·NULL률, KS 검정 | 의미적 변화 | 높음 |
| 6. 리포트 수치 | 최종 리포트 값 비교 | 현업 승인 근거 | 최고 |
해시 합의 핵심은 정규화다. 숫자 포맷(FM9999999990.00), 날짜 포맷, 트림, NULL 표기를 양쪽에서 동일하게 통일한 문자열에 같은 알고리즘을 적용해야 하며, 부동소수·타임존·문자셋 정규화 없이 비교하면 거짓 불일치가 폭증하는 것이 실패 모드다. CDC 지연이 커진 상태에서 비교하면 정상 지연이 불일치로 오탐되므로 비교 시점을 워터마크 기준으로 맞춘다.
합격 기준은 사전에 합의해 자동 게이트로 만든다.
| 대상 | 허용 오차 | 연속 일치 요건 |
|---|---|---|
| 규제 보고 40개 | 불일치 0건(금액 합 차 0, 행 수 차 0) | 2주 연속 + 월말 마감 1회 포함 |
| 일반 리포트 | 금액 합 상대 오차 0.01% 이내, 분포 p-value > 0.05 | 2주 연속 |
| 마트 테이블 | 행 수 0, 해시 합 일치 파티션 100% | 10 영업일 연속 |
비교 결과는 테이블로 적재해 대시보드·알림으로 노출하고, N주 연속 일치 시 컷오버 게이트가 자동 통과한다. 도구는 자체 SQL + 오케스트레이터를 기본으로 하고 datacompy·Great Expectations cross-table Expectation(검증 규칙)을 보조로 쓴다.
7. 컷오버·롤백·레거시 폐기
컷오버 승인 조건(정량): ① Reconciliation 2주 연속 일치(규제 보고는 월말 포함), ② 성능 벤치마크에서 레거시 상위 N 쿼리 p95 저하 없음, ③ 현업 리포트 인수 승인, ④ 보안 점검 통과, ⑤ 롤백 리허설 1회 완료, ⑥ 하이퍼케어 인력 배치. 하나라도 미충족이면 Wave를 연기한다.
컷오버 절차: 금요일 야간 프리즈 윈도우(2시간) → 증분 동기화 수렴 확인(CDC 지연 0) → 레거시 쓰기 차단 → 최종 CDC 적용 → 1~3계층 검증 → 뷰/alias 정의를 신 플랫폼으로 교체 → BI 연결 전환 → 월요일 업무 개시까지 하이퍼케어. 읽기 전환을 먼저 하고 쓰기 전환을 분리하면 전환 윈도우는 길어지지만 리스크가 낮아진다.
롤백 조건(정량): 컷오버 후 72시간 내 핵심 리포트 수치 불일치 1건 이상, 파이프라인 SLA 위반 2회, P1 장애 1회, 규제 보고 지연 위험 중 하나라도 발생. 롤백은 뷰/alias를 레거시로 복귀시키는 것으로 즉시 수행되며, 이를 위해 레거시 쓰기(ETL)는 롤백 윈도우가 닫힐 때까지 유지한다. 신 플랫폼에 쌓인 변경을 레거시로 역동기화(reverse CDC)할지는 Wave 설계 시 결정하고, 역동기화가 불가능하면 레거시 read-only 전환을 롤백 윈도우 이후로 미룬다. 레거시는 Wave 완료 후 최소 2주 유지한다.
폐기 기준: 신규 경로 30일 안정(SLA 위반 0) + 소비자 접근 0 확인(쿼리 로그 30일) + 사용자 승인 + 최종 스냅샷을 규제 보존 기간 동안 불변 저장(S3 Object Lock) + 복원 테스트 1회 → 라이선스·하드웨어 종료(디스크 소거 증적). 카탈로그에 폐기 표시하고 비용 절감을 보고한다.
8. 규제·보안
규제 절차는 일정의 임계 경로이므로 Discovery와 병렬인 Wave 0으로 착수한다. 금융분야 클라우드 이용 가이드(2025)가 정리한 전자금융감독규정 제14조의2 기반 절차 — 업무 선정·중요도 평가 → CSP 건전성·안전성 평가 → 안전성 확보조치 → 정보보호위원회 심의 → 계약 → 이용·사후보고 → 종료 — 를 Wave마다 산출물 게이트로 둔다. 비중요 업무를 Pilot으로 먼저 올리면 절차가 가볍고, 중요업무(개인신용정보 포함 마트·규제 보고)는 중요도 평가 결과에 따라 Wave 2 이후로 배치한다. 망분리 완화·디지털금융 관련 법 제정 추진은 세부 요건·시행 시점이 확인 필요이므로, 답안은 "완화 추세를 활용하되 자율보안·결과책임 원칙에 따라 통제 증적을 더 강하게 갖춘다"로 둔다.
보안 설계는 다음을 포함한다. (1) 데이터 레지던시: 개인신용정보·중요업무 데이터는 국내 리전, DR 리전의 국외 사용 여부는 확인 필요. (2) 암호화: S3 SSE-KMS 고객 관리 키, 전송은 전용선 + IPsec/TLS 1.2+, 민감 컬럼은 Silver 진입 시 결정론적 토큰화. (3) 접근제어: Lake Formation 열·행 정책, 서비스 간 역할 위임, 장기 키 금지. (4) 감사: CloudTrail·S3 액세스 로그·정책 변경 로그를 WORM 저장. (5) 전환 중 유출 통제: 초기 적재 반출 디바이스 암호화·봉인·추적, 비운영 환경은 마스킹 복제본만, DMS/Spark 중간 버킷 수명주기 정책, 로그에 데이터 값 기록 금지, 협력사 세션 기록. 전환 중 통제는 자주 누락되지만 가장 큰 사고가 나는 지점이다.
9. 비용(FinOps)·운영 SLO
TCO는 5년 시계열로 연도별 비교하고 손익분기 시점을 제시한다. 흔한 오류는 이중 운영 기간(본 설계는 Pilot~Wave 3 약 12개월)과 전환 비용(이관 도구·외부 인력·교육·전송), 온프레미스 인건비를 누락하는 것이며, 이를 포함해도 30% 절감이 성립하는지를 Discovery에서 ±30% 정확도로, Wave 1 후 ±10%로 재산정한다. 절감 수단은 Retire 30%로 이관 범위 축소, 스토리지 계층화와 스냅샷 만료, 배치·백필의 스팟 사용, 상시 부하 확정 후 예약(전환 초기 예약 금지), 서버리스의 상시 고부하 비용 역전 감시다. 태깅 표준(도메인·환경·Wave)으로 “이중 운영 비용” 라인을 별도 추적해 종료 시점의 절감을 증명한다.
SLO는 신선도(핵심 테이블 15분, 99% 기간), 파이프라인 가용성(일 성공률 99.5%), 대시보드 쿼리 p95 < 5초, 정합성(Reconciliation 일치율 100%, 허용 오차 내), 에러 버짓 소진 시 변경 동결로 정의한다. DR은 계층별 차등(Raw RPO 15분/RTO 4시간, 마트는 재생성 가능하므로 RTO 중심)으로 멀티 AZ를 기본으로 하고, 멀티 리전은 데이터 레지던시 규제와 비용을 고려해 중요 업무만 적용한다. 런북은 CDC 지연 증가·품질 게이트 실패·뷰 롤백·키 유출·침해(compromise)를 포함하고, 전환 기간에는 레거시 팀과 공동 온콜을 운영한다.
10. 리스크 레지스터
| # | 리스크 | 영향 | 확률 | 완화책(연결 절) | 조기 경보 |
|---|---|---|---|---|---|
| 1 | PL/SQL 변환 품질 → 집계 불일치 | 높음 | 높음 | 동등성 테스트 자동화, 복잡 잡 조기 착수, 리니지 기준 재설계(§5) | 동등성 테스트 실패율 |
| 2 | CDC 지연·누락, DBA의 redo 부하 반대 | 높음 | 중간 | 스탠바이 추출, 보조 로깅 사전 합의, 지연 SLO·재동기화 런북(§4·5) | CDC 지연 초 |
| 3 | 정합성 불일치(타입·타임존·NULL) | 높음 | 높음 | 매핑 표, 6계층 자동 검증, 허용 오차 합의(§5·6) | 불일치 파티션 수 추세 |
| 4 | 이중 운영 피로·일정 지연 | 중간 | 높음 | Wave 크기 축소, Retire 우선, 외부 인력, 종료일 고정(§2·9) | 온콜 호출 수 |
| 5 | 규제 승인 지연 | 매우 높음 | 중간 | Wave 0 병렬 착수, 비중요 Pilot 선행, 절차 산출물 게이트(§8) | 미완료 절차 항목 |
| 6 | 비용 초과(이중 운영 장기화·서버리스 역전·egress) | 높음 | 높음 | FinOps 태깅·예산 알림, 예약 재산정(§9) | 월 지출 vs 계획 |
| 7 | 리포트 호환 실패 | 높음 | 높음 | 뷰 추상화, 골든 리포트 회귀 테스트, 하이퍼케어(§4·7) | 리포트 오류 티켓 |
| 8 | 성능 저하(레이크하우스 < Exadata) | 높음 | 중간 | 운영 규모 벤치마크, 파티션·정렬·컴팩션, 엔진 분리(§4) | p95 vs 기준선 |
| 9 | 핵심 인력 이탈(PL/SQL 의미 소실) | 높음 | 중간 | Discovery에서 문서화·녹화, 외부 전문가 페어링 | 퇴직 의향 |
| 10 | 전환 중 데이터 유출 | 매우 높음 | 낮음 | 반출·비운영·임시 파일 통제, 접근 로그 감사(§8) | 비운영 민감 데이터 스캔 |
| 11 | 라이선스 만료 전 미완료 | 매우 높음 | 중간 | M16 컷오버 목표로 2개월 버퍼, 단기 연장 옵션 사전 협상 | Wave 지연 일수 |
| 12 | 범위 확산 | 중간 | 높음 | Out of scope 명문화, Strangler로 신규는 신 플랫폼에만 | 변경 요청 수 |
11. 로드맵(18개월)과 단계별 진입·종료 기준

(손그림: 왼쪽에서 오른쪽으로 박스 6개, 박스 사이에 게이트 G0~G4를 마름모로.)
| 단계 | 기간 | 진입 기준 | 종료 기준 |
|---|---|---|---|
| Wave 0 / Discovery | M0~2 | 스폰서·범위·예산 승인 | 자산 대장·의존성 그래프·민감 맵·품질 기준선·KPI 기준선·7R 매핑 완료, 중요도 평가 착수, 비용 모델 ±30% |
| Pilot | M3~5 | 비중요 업무 선정, 보안 심의 통과, CDC PoC(스탠바이 부하 측정) 완료 | end-to-end 4주 운영, SLO 충족, Reconciliation 프레임워크 가동, 런북 존재, 내부 인력 전원 참여 |
| Wave 1 | M6~8 | Pilot 교훈 반영, 도메인 팀 온보딩 | 단순 적재 잡 Replatform 완료, 2주 연속 일치, 리포트 승인, 이중 운영 비용 추적 개시 |
| Wave 2 | M9~12 | Wave 1 안정화 2주 이상 | 임계 경로 증분화로 배치 완료 04:00 이내, 복잡 PL/SQL 동등성 테스트 통과율 90% 이상(가정) |
| Wave 3 | M13~16 | 중요도 평가 통과, 검증 프레임워크 성숙 | 규제 보고 Parallel Run 8주(월말 2회 포함) 불일치 0, 컷오버 완료 |
| 관찰·폐기 | M16~18 | 모든 소비자 전환, 롤백 윈도우 종료 | 접근 0 확인 30일, 백업 보관·복원 테스트, 라이선스 종료 |
M16 컷오버 목표는 라이선스 만료(M18)까지 2개월 버퍼를 확보하기 위한 것이며, 버퍼가 소진될 위험에 대비해 단기 연장 옵션을 사전에 협상한다. 조직 측면에서는 Wave 0~1은 중앙 플랫폼 팀이 표준을 세우고, Wave 2부터 계리·보험금 도메인에 데이터 프로덕트 오너십을 부여하는 하이브리드 운영 모델을 적용하며, DBA → 플랫폼 엔지니어, ETL 개발자 → 분석 엔지니어(dbt/Spark)로의 역할 전환 교육을 Pilot에서 시작한다.
12. 결론
본 설계는 라이선스 만료라는 기한을 M16 컷오버 + 2개월 버퍼로 흡수하고, 1,200개 잡과 규제 보고 40개의 리스크를 Retire 30% → Replatform → Refactor 순의 Phased + Strangler로 분산하며, 정합성은 CDC 시작점 고정·듀얼 라이트 배제·6계층 Reconciliation·정량적 컷오버/롤백 게이트로 증명한다. 배치 윈도우는 컴퓨트 증설이 아니라 임계 경로의 증분화로 해결하고, 비용 30%는 Retire·계층화·스팟·예약 재산정과 이중 운영 비용의 별도 추적으로 입증한다. 핵심 트레이드오프는 ① Refactor 비중(유지보수성) vs 병행 운영 기간(비용), ② Parallel Run의 확신 vs 2배 비용, ③ 관리형 서비스의 속도 vs 이식성(Iceberg·REST 카탈로그·IaC로 완화)이다.
